Validation croisée et ajustement des hyperparamètres
CSI 4506 - automne 2026
Version: sept. 25, 2026 08h44
Préambule
Message du jour
Objectifs d’apprentissage
- Distinguer les rôles des données d’entraînement, de validation et de test dans le développement du modèle et son évaluation finale.
- Expliquer comment la validation croisée à k plis entraîne un nouveau modèle à chaque itération, puis interpréter la moyenne et l’écart-type de scores de plis qui ne sont pas indépendants.
- Prévenir les fuites de données en ajustant le prétraitement dans chaque pli et en appliquant les transformations mémorisées aux exemples de validation et de test.
- Distinguer les paramètres appris par le modèle des hyperparamètres et expliquer pourquoi les hyperparamètres qui interagissent doivent être évalués conjointement.
- Appliquer
GridSearchCVpour ajuster plusieurs pipelines avec une métrique commune et expliquer quand une recherche aléatoire est utile. - Comparer les familles de modèles ajustées, réajuster le pipeline sélectionné sur toutes les données d’entraînement et l’évaluer une seule fois sur l’ensemble de test intact.
Introduction
Jeu de données : OpenML
OpenML est une plateforme ouverte pour partager des jeux de données, des algorithmes et des expériences afin d’améliorer collectivement les méthodes d’apprentissage.
Jeu de données : OpenML
Author: Vincent Sigillito
Source: Obtained from UCI
Please cite: UCI citation policy
Title: Pima Indians Diabetes Database
Sources:
- Original owners: National Institute of Diabetes and Digestive and Kidney Diseases
- Donor of database: Vincent Sigillito (vgs@aplcen.apl.jhu.edu) Research Center, RMI Group Leader Applied Physics Laboratory The Johns Hopkins University Johns Hopkins Road Laurel, MD 20707 (301) 953-6231
- Date received: 9 May 1990
Past Usage:
Smith,J.W., Everhart,J.E., Dickson,W.C., Knowler,W.C., & Johannes,R.S. (1988). Using the ADAP learning algorithm to forecast the onset of diabetes mellitus. In {it Proceedings of the Symposium on Computer Applications and Medical Care} (pp. 261–265). IEEE Computer Society Press.
The diagnostic, binary-valued variable investigated is whether the patient shows signs of diabetes according to World Health Organization criteria (i.e., if the 2 hour post-load plasma glucose was at least 200 mg/dl at any survey examination or if found during routine medical care). The population lives near Phoenix, Arizona, USA.
Results: Their ADAP algorithm makes a real-valued prediction between 0 and 1. This was transformed into a binary decision using a cutoff of 0.448. Using 576 training instances, the sensitivity and specificity of their algorithm was 76% on the remaining 192 instances.
Relevant Information: Several constraints were placed on the selection of these instances from a larger database. In particular, all patients here are females at least 21 years old of Pima Indian heritage. ADAP is an adaptive learning routine that generates and executes digital analogs of perceptron-like devices. It is a unique algorithm; see the paper for details.
Number of Instances: 768
Number of Attributes: 8 plus class
For Each Attribute: (all numeric-valued)
- Number of times pregnant
- Plasma glucose concentration a 2 hours in an oral glucose tolerance test
- Diastolic blood pressure (mm Hg)
- Triceps skin fold thickness (mm)
- 2-Hour serum insulin (mu U/ml)
- Body mass index (weight in kg/(height in m)^2)
- Diabetes pedigree function
- Age (years)
- Class variable (0 or 1)
Missing Attribute Values: None
Class Distribution: (class value 1 is interpreted as “tested positive for diabetes”)
Class Value Number of instances 0 500 1 268
Brief statistical analysis:
Attribute number: Mean: Standard Deviation:
3.8 3.4120.9 32.069.1 19.420.5 16.079.8 115.232.0 7.90.5 0.333.2 11.8
Relabeled values in attribute ‘class’ From: 0 To: tested_negative
From: 1 To: tested_positive
Downloaded from openml.org.
Jeu de données : return_X_y
fetch_openml retourne un objet Bunch par défaut, ou X et y lorsque return_X_y=True.
La classe positive est moins fréquente, mais les deux classes contiennent assez d’exemples pour une validation croisée stratifiée.
Mesures manquantes
Selon la convention adoptée dans la version corrigée PimaIndiansDiabetes2 de ce jeu de données, les valeurs nulles de cinq mesures cliniques sont traitées comme des valeurs manquantes (missing values). La valeur zéro demeure valide pour le nombre de grossesses.
Validation croisée
Ensembles d’entraînement et de test
Cette division est souvent appelée méthode de retenue (holdout method).
Point de départ courant : allouer 80 % des données à l’entraînement et réserver 20 % pour le test.
Ensemble d’entraînement : utilisé pour ajuster les modèles et prendre les décisions de modélisation.
Ensemble de test : sous-ensemble indépendant utilisé une seule fois pour l’évaluation finale.
Ensembles d’entraînement et de test
Erreur d’entraînement : erreur de prédiction mesurée sur les exemples qui ont servi à ajuster le modèle.
- L’ajustement cherche généralement à réduire la perte ou l’erreur d’entraînement.
- Une faible erreur d’entraînement ne garantit pas une faible erreur de généralisation.
Ensembles d’entraînement et de test
Erreur de généralisation : erreur de prédiction attendue sur de nouveaux exemples provenant de conditions semblables.
Elle ne peut pas être observée directement. Les scores de validation et de test l’estiment à partir d’échantillons finis.
Ensembles d’entraînement et de test
Sous-ajustement (underfitting):
- Erreur d’entraînement élevée.
- Le modèle est trop simple pour représenter les régularités sous-jacentes.
- La performance est faible sur les données d’entraînement et les nouvelles données.
Surajustement (overfitting) :
- Erreur d’entraînement faible, mais erreur de généralisation élevée.
- Le modèle représente du bruit ou des régularités non pertinentes.
- La performance est faible sur de nouvelles données.
Définition
La validation croisée estime la performance d’une procédure de construction de modèle sur des exemples inédits.
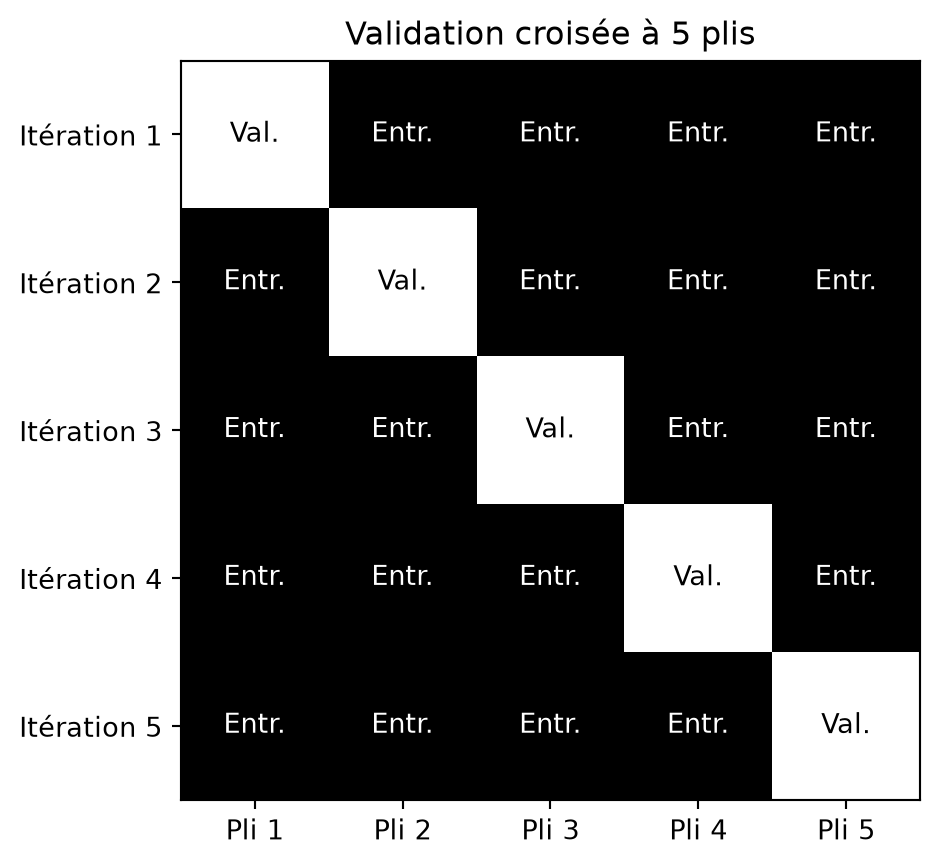
Elle partitionne plusieurs fois les données d’entraînement, entraîne un nouveau classificateur sur certains plis et évalue ce classificateur sur le pli restant. L’ensemble de test demeure intact.
Validation croisée à k plis
- Diviser les données d’entraînement en k parties approximativement égales, appelées plis.
- Répéter k fois :
- Partir d’un nouveau classificateur non ajusté.
- L’entraîner sur k-1 plis.
- L’évaluer sur le pli de validation restant.
- Agrégation : résumer les k scores produits par les k classificateurs entraînés séparément.
Code
import matplotlib.pyplot as plt

def plot_k_fold_cross_validation(k):
    fig, ax = plt.subplots()

    matrix = np.ones((k, k))
    np.fill_diagonal(matrix, 0)

    ax.imshow(matrix, cmap="binary", interpolation="none")

    for i in range(k):
        for j in range(k):
            label = "Val." if i == j else "Entr."
            color = "black" if i == j else "white"
            ax.text(j, i, label, ha="center", va="center", color=color)

    ax.set_xticks(np.arange(k))
    ax.set_yticks(np.arange(k))
    ax.set_xticklabels([f"Pli {i+1}" for i in range(k)])
    ax.set_yticklabels([f"Itération {i+1}" for i in range(k)])
    plt.title(f"Validation croisée à {k} plis")

    ax.grid(False)
plt.show()Validation croisée à 5 plis
Évaluation sur les plis de validation
- Pendant la sélection du modèle, la validation croisée moyenne les scores de plusieurs plis de validation plutôt que de dépendre d’une seule partition.
- Un score par pli révèle la sensibilité aux exemples de validation particuliers.
- La moyenne et l’écart-type résument les scores des plis, mais ceux-ci ne sont pas indépendants.
Estimation de la généralisation
- La validation croisée estime la performance sur des exemples inédits provenant de conditions semblables.
- Elle n’améliore pas directement la généralisation. Elle permet de comparer les choix de modélisation en utilisant uniquement les données d’entraînement.
- L’ensemble de test intact fournit l’évaluation finale après ces choix.
Utilisation efficace des données
- La validation croisée est particulièrement utile lorsque les données sont limitées.
- Au fil des k itérations, chaque exemple d’entraînement apparaît une fois dans un pli de validation et k-1 fois dans un pli d’ajustement.
- Après la sélection, la procédure choisie peut être réajustée sur l’ensemble d’entraînement complet.
Ajustement des hyperparamètres
- La validation croisée compare des configurations d’hyperparamètres avec les mêmes plis et la même métrique d’évaluation.
- La configuration sélectionnée possède la meilleure performance estimée parmi les candidates évaluées.
Défis
- Coût de calcul : la validation exige des ajustements répétés.
- La méthode leave-one-out (LOO) représente le cas extrême où (k=N).
- Déséquilibre des classes : des plis aléatoires peuvent mal représenter les classes minoritaires.
- La validation croisée stratifiée maintient approximativement les proportions des classes.
- Complexité de mise en œuvre : les implémentations manuelles favorisent les erreurs, surtout avec la validation croisée imbriquée, le rééchantillonnage bootstrap ou l’intégration à des pipelines plus complexes.
Ajustement des hyperparamètres
Flux de travail
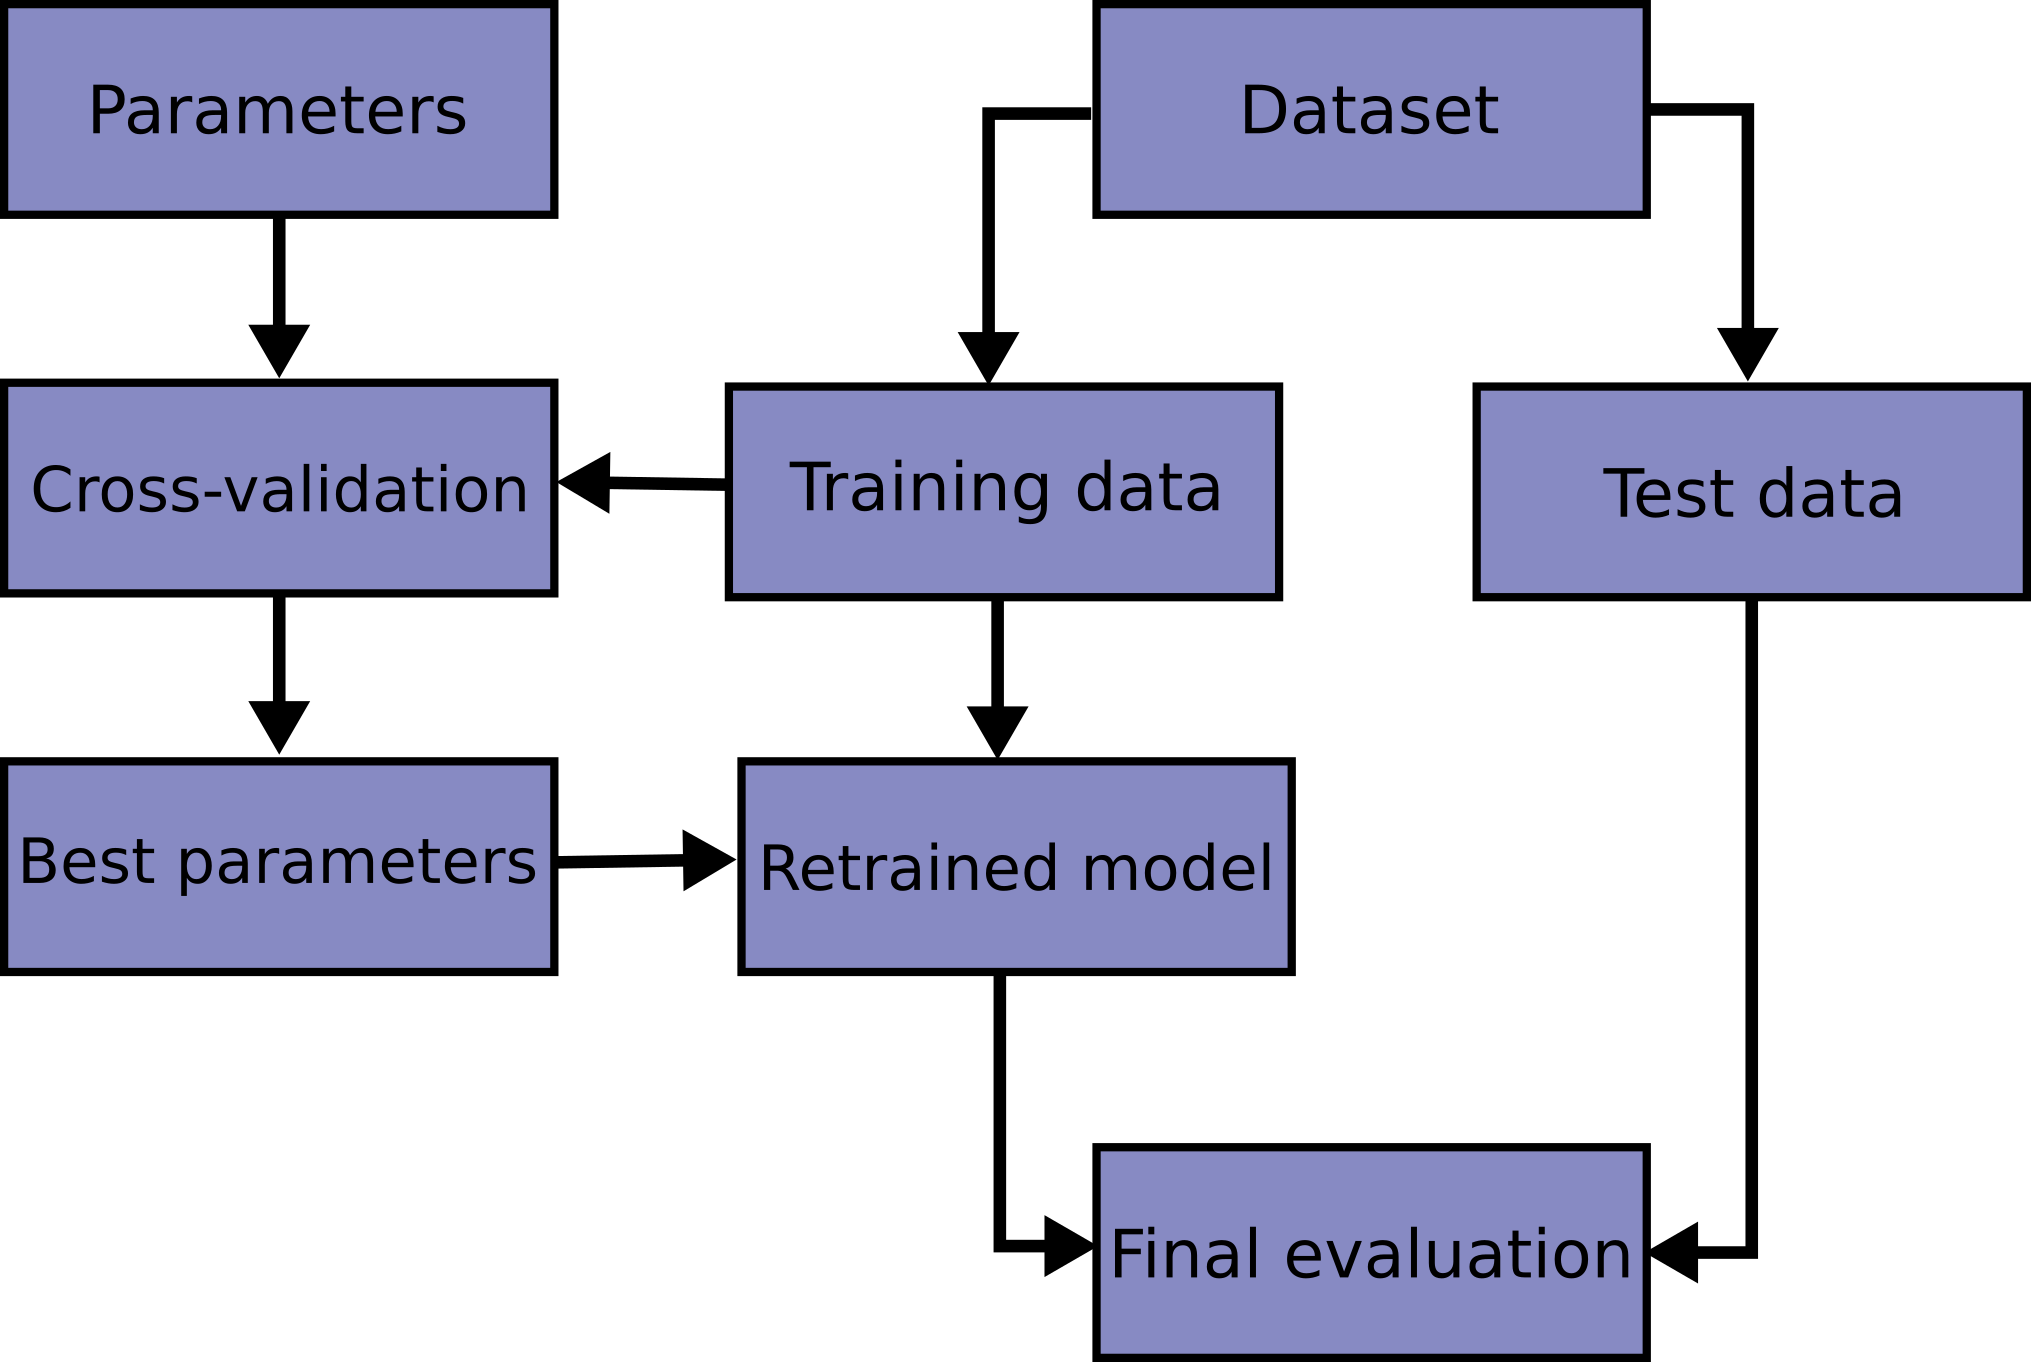
Flux de travail : mise en œuvre
Fuite de données pendant la validation croisée
Une fuite de données (data leakage) survient lorsque l’information d’un pli de validation influence la procédure ajustée sur les autres plis.
Les exemples de validation influencent les moyennes et les échelles qui servent à les évaluer.
fit_transform et transform
fit(X)apprend de l’information à partir deX.fit_transform(X)apprend cette information et applique la transformation aux mêmes exemples.transform(X)applique l’information mémorisée sans la recalculer.
Les exemples de validation, de test et les exemples futurs reçoivent transform, jamais fit ou fit_transform.
Prétraitement dans chaque pli
Pour chaque pli, la validation croisée crée et ajuste un nouveau pipeline.
| Étape du pipeline | Plis d’ajustement | Pli de validation |
|---|---|---|
| Imputation | fit_transform |
transform |
| Mise à l’échelle | fit_transform |
transform |
| Classificateur | fit |
predict_proba / decision_function |
Les médianes, les moyennes et les échelles apprises ne sont pas transmises au pli suivant.
Pipelines de prétraitement
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.tree import DecisionTreeClassifier

tree_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("model", DecisionTreeClassifier(random_state=seed)),
])

knn_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler()),
    ("model", KNeighborsClassifier()),
])

logistic_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler()),
    ("model", LogisticRegression(
        solver="saga",
        max_iter=3000,
        random_state=seed,
    )),
])cross_val_score
Scores : [0.81133721 0.76061047 0.84447674 0.74883721 0.75639881]
AUROC moyenne : 0.784
Écart-type : 0.037Paramètres et hyperparamètres
Les paramètres du modèle sont appris à partir des données d’entraînement.
Les hyperparamètres sont choisis avant chaque ajustement et contrôlent la structure du modèle ou le processus d’apprentissage.
Hyperparamètres : arbre de décision
criterionchoisit la mesure de qualité d’une division :gini,entropyoulog_loss.max_depthlimite la profondeur maximale de l’arbre.
Hyperparamètres : régression logistique
Creprésente l’inverse de la force de régularisation. Les petites valeurs appliquent une régularisation plus forte.l1_ratiochoisit l’équilibre entre les régularisations L2 et L1 lorsque le solveursagaest utilisé.
Hyperparamètres : KNN
n_neighborsindique le nombre de voisins utilisés pour effectuer une prédiction.weightsdonne la même influence aux voisins (uniform) ou une influence plus grande aux voisins proches (distance).
Expérience : n_neighbors
neighbor_scores = {}
neighbor_values = [1, 3, 5, 7, 9, 11, 15, 21, 31]

for value in neighbor_values:
    candidate = knn_pipeline.set_params(
        model__n_neighbors=value,
        model__weights="uniform",
    )
    scores = cross_val_score(
        candidate,
        X_train,
        y_train,
        cv=cv,
        scoring=selection_metric,
    )
    neighbor_scores[value] = scores.mean()
    print(f"n_neighbors={value:2d} : {scores.mean():.3f}")

best_n_neighbors = max(neighbor_scores, key=neighbor_scores.get)
print("Meilleur n_neighbors :", best_n_neighbors)
Expérience : n_neighbors
n_neighbors= 1 : 0.664
n_neighbors= 3 : 0.764
n_neighbors= 5 : 0.784
n_neighbors= 7 : 0.798
n_neighbors= 9 : 0.815
n_neighbors=11 : 0.822
n_neighbors=15 : 0.832
n_neighbors=21 : 0.831
n_neighbors=31 : 0.831
Meilleur n_neighbors : 15
Expérience : weights
weight_scores = {}

for value in ["uniform", "distance"]:
    candidate = knn_pipeline.set_params(
        model__n_neighbors=best_n_neighbors,
        model__weights=value,
    )
    scores = cross_val_score(
        candidate,
        X_train,
        y_train,
        cv=cv,
        scoring=selection_metric,
    )
    weight_scores[value] = scores.mean()
    print(f"weights={value:8s} : {scores.mean():.3f}")
weights=uniform : 0.832
weights=distance : 0.833Ajustement des hyperparamètres : recherche en grille
Plusieurs hyperparamètres doivent parfois être considérés conjointement.
L’exploration manuelle de leurs combinaisons devient fastidieuse et propice aux erreurs.
La recherche en grille évalue systématiquement un ensemble prédéfini de combinaisons :
Énumérer le produit cartésien des valeurs candidates.
Évaluer chaque combinaison avec les mêmes plis de validation croisée et la même métrique.
GridSearchCV : arbre de décision
from sklearn.model_selection import GridSearchCV

tree_param_grid = {
    "model__max_depth": [2, 3, 4, 5, 6, None],
    "model__criterion": ["gini", "entropy", "log_loss"],
}

tree_search = GridSearchCV(
    tree_pipeline,
    tree_param_grid,
    cv=cv,
    scoring=selection_metric,
)
tree_search.fit(X_train, y_train)

(tree_search.best_params_, tree_search.best_score_)
({'model__criterion': 'gini', 'model__max_depth': 4},
np.float64(0.7881160022148395))GridSearchCV : KNN
({'model__n_neighbors': 21, 'model__weights': 'distance'},
np.float64(0.8336620985603543))GridSearchCV : régression logistique
({'model__C': 0.1, 'model__l1_ratio': 0.0}, np.float64(0.8443867663344408))Comparaison des modèles ajustés
model_searches = {
    "Arbre de décision": tree_search,
    "KNN": knn_search,
    "Régression logistique": logistic_search,
}

for name, search in model_searches.items():
    print(f"{name:22s} : {search.best_score_:.3f}")

best_model_name = max(
    model_searches,
    key=lambda name: model_searches[name].best_score_,
)
best_search = model_searches[best_model_name]

print("Modèle sélectionné :", best_model_name)
Arbre de décision : 0.788
KNN : 0.834
Régression logistique : 0.844
Modèle sélectionné : Régression logistiqueRecherche aléatoire
- Une grille devient coûteuse lorsqu’elle contient de nombreuses combinaisons.
RandomizedSearchCVéchantillonne des candidates à partir des valeurs ou des distributions fournies.- Le nombre d’itérations établit un budget de calcul prévisible.
Flux de travail
Évaluation finale
from sklearn.metrics import classification_report, roc_auc_score

best_model = best_search.best_estimator_

y_test_score = best_model.predict_proba(X_test)[:, 1]
y_test_pred = best_model.predict(X_test)

print("Modèle sélectionné :", best_model_name)
print(f"AUROC de test : {roc_auc_score(y_test, y_test_score):.3f}")
print(classification_report(y_test, y_test_pred))
Modèle sélectionné : Régression logistique
AUROC de test : 0.810
precision recall f1-score support
0 0.74 0.80 0.77 100
1 0.57 0.48 0.52 54
accuracy 0.69 154
macro avg 0.65 0.64 0.64 154
weighted avg 0.68 0.69 0.68 154
Conclusion
Résumé (1/2)
- Nous avons réservé un ensemble de test intact à une évaluation finale unique, après toutes les décisions de modélisation.
- Nous avons utilisé la validation croisée à k plis pour entraîner un nouveau modèle à chaque itération et résumer les scores de plis liés entre eux par leur moyenne et leur écart-type.
- Nous avons prévenu les fuites de données en ajustant l’imputation et la mise à l’échelle dans chaque pli, puis en appliquant les transformations mémorisées aux exemples de validation et de test.
Résumé (2/2)
- Nous avons distingué les paramètres du modèle appris des hyperparamètres, puis évalué conjointement les hyperparamètres qui interagissent.
- Nous avons utilisé
GridSearchCVpour ajuster et comparer des pipelines d’arbre de décision, de KNN et de régression logistique avec les mêmes plis et la même métrique AUROC. La recherche aléatoire offre une solution de rechange pour les espaces de recherche plus vastes. - Nous avons réajusté le pipeline sélectionné sur toutes les données d’entraînement et évalué celui-ci une seule fois sur l’ensemble de test. Toute modification ultérieure transformerait cet ensemble de test en données de validation.
Prochain cours
- Après le quiz, nous aborderons l’ingénierie de l’apprentissage automatique.
Références
Marcel Turcotte
École de science informatique et de génie électrique (SIGE)
Université d’Ottawa