Attribuer \hat{y}_i = 0 si h_\theta(x_i) < 0.5; \hat{y}_i = 1 si h_\theta(x_i) \geq 0.5
Le vecteur de paramètres \theta est optimisé par descente de gradient.
Quelle fonction de perte faut-il utiliser, et pourquoi?
Remarques
Lors de la construction d’un modèle d’apprentissage automatique avec des bibliothèques comme scikit-learn ou keras, il faut choisir une fonction de perte ou accepter celle par défaut.
Au début, la terminologie peut prêter à confusion, car une même fonction peut porter plusieurs noms.
Notre objectif est de clarifier cette terminologie.
En réalité, ce n’est pas si compliqué!
Estimation des paramètres
La régression logistique est un modèle statistique.
Sa sortie est \hat{p} = P(y = 1 \mid x, \theta).
P(y = 0 \mid x, \theta) = 1 - \hat{p}.
On suppose que les valeurs de y proviennent d’une loi de Bernoulli.
On détermine généralement \theta par estimation du maximum de vraisemblance.
Estimation des paramètres
L’estimation du maximum de vraisemblance (EMV) est une méthode statistique qui permet d’estimer les paramètres d’un modèle probabiliste.
Elle détermine les valeurs des paramètres qui maximisent la fonction de vraisemblance, laquelle mesure à quel point le modèle explique les données observées.
Fonction de vraisemblance
Si les valeurs de y sont indépendantes et identiquement distribuées (i.i.d.), la fonction de vraisemblance s’exprime comme le produit des probabilités individuelles.
Autrement dit, pour les données \{(x_i, y_i)\}_{i=1}^N, la fonction de vraisemblance est :
Les algorithmes d’arbres de décision emploient souvent l’entropie, une mesure issue de la théorie de l’information, pour évaluer la qualité des divisions ou des partitions.
L’entropie quantifie l’incertitude ou l’impureté associée aux résultats possibles d’une variable aléatoire.
Entropie
En théorie de l’information, l’entropie quantifie l’incertitude ou l’imprévisibilité des résultats possibles d’une variable aléatoire. Elle mesure l’information moyenne associée à un résultat. Avec un logarithme en base 2, l’entropie est mesurée en bits. L’entropie H d’une variable aléatoire discrète X, dont les valeurs possibles sont \{x_1, x_2, \ldots, x_n\} et dont la fonction de masse est P(X), est donnée par :
H(X) = -\sum_{i=1}^n P(x_i) \log_2 P(x_i)
Entropie croisée
L’entropie croisée mesure la pénalité moyenne associée aux probabilités prédites par q, en utilisant p pour pondérer les résultats possibles.
H(p, q) = -\sum_{k} p_k \log q_k
Entropie croisée
Pour une étiquette binaire, la distribution observée est (y_i, 1-y_i).
La distribution de Bernoulli prédite est (\hat{p}_i, 1-\hat{p}_i).
Leur entropie croisée, notée \ell_i, est la perte associée à l’exemple i.
Entropie croisée
Considérons la fonction de perte de log-vraisemblance négative :
Pour le modèle de Bernoulli, la log-vraisemblance négative moyenne est l’entropie croisée binaire.
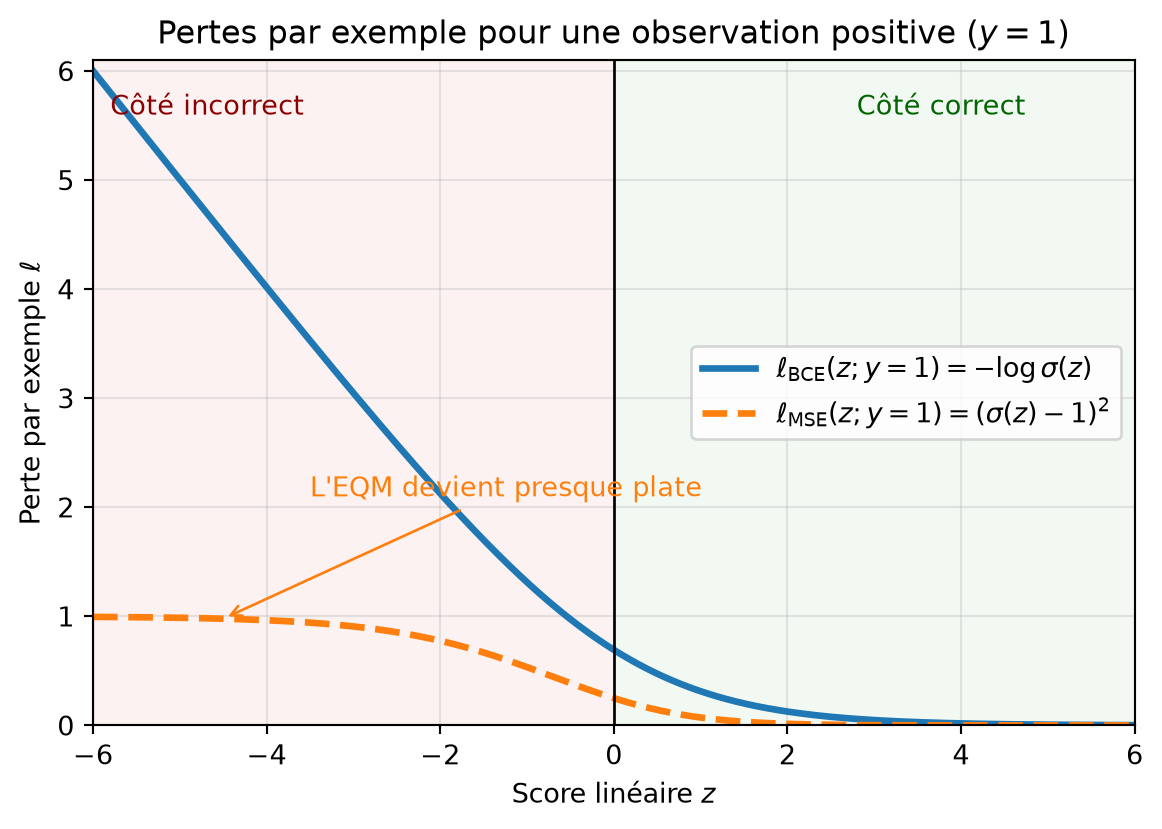
ECB et EQM pour un exemple positif
Code
import matplotlib.pyplot as pltimport numpy as nprng = np.random.default_rng(42)# Fonction sigmoïdedef sigmoid(t):return1/ (1+ np.exp(-t))# Comparer les pertes en fonction du score linéaire z lorsque y = 1.z_values = np.linspace(-6, 6, 1000)p_values = sigmoid(z_values)bce_values =-np.log(p_values)mse_values = (p_values -1) **2fig, ax = plt.subplots(figsize=(7, 4.5))ax.axvspan(-6, 0, color='tab:red', alpha=0.06)ax.axvspan(0, 6, color='tab:green', alpha=0.06)ax.plot( z_values, bce_values, color='tab:blue', linewidth=2.5, label=r'$\ell_{\mathrm{BCE}}(z;y=1)=-\log \sigma(z)$',)ax.plot( z_values, mse_values, color='tab:orange', linewidth=2.5, linestyle='--', label=r'$\ell_{\mathrm{MSE}}(z;y=1)=(\sigma(z)-1)^2$',)ax.axvline(0, color='black', linewidth=1)ax.text(-5.8, 5.6, 'Côté incorrect', color='darkred')ax.text(2.8, 5.6, 'Côté correct', color='darkgreen')ax.annotate("L'EQM devient presque plate", xy=(-4.5, mse_values[np.argmin(np.abs(z_values +4.5))]), xytext=(-3.5, 2.1), arrowprops={'arrowstyle': '->', 'color': 'tab:orange'}, color='tab:orange',)ax.set_xlim(-6, 6)ax.set_ylim(0, 6.1)ax.set_xlabel(r'Score linéaire $z$')ax.set_ylabel(r'Perte par exemple $\ell$')ax.set_title(r'Pertes par exemple pour une observation positive ($y=1$)')ax.grid(True, alpha=0.3)ax.legend()plt.show()
Pourquoi ne pas utiliser l’EQM?
L’entropie croisée binaire est la log-vraisemblance négative du modèle de Bernoulli.
Avec l’entropie croisée binaire, l’objectif de la régression logistique est convexe par rapport aux paramètres.
Avec une sortie sigmoïde, l’EQM n’est pas globalement convexe par rapport au score linéaire. Son gradient peut aussi devenir très faible lorsque le modèle produit avec confiance une prédiction incorrecte.
Interprétation géométrique
Interprétation géométrique
Soit w=(\theta_1,\ldots,\theta_D)^\top le vecteur des poids des attributs.
La partie du score linéaire qui dépend des attributs est un produit scalaire :
w^\top x = \theta_1 x_1 + \theta_2 x_2 + \ldots + \theta_D x_D.
Le score linéaire complet comprend l’ordonnée à l’origine :
t(x)=\theta_0 + w^\top x.
Le produit scalaire possède une interprétation géométrique.
w^\top x = \|w\|\|x\|\cos\phi
Interprétation géométrique
w^\top x = \|w\|\|x\|\cos\phi
Le produit scalaire dépend à la fois de la norme des vecteurs et de l’angle qui les sépare.
Il est positif lorsque l’angle est aigu, et négatif lorsque l’angle est obtus.
Il est nul lorsque les vecteurs sont perpendiculaires(\phi=90^\circ).
Interprétation géométrique
La régression logistique applique la sigmoïde au score linéaire t(x)=\theta_0+w^\top x.
L’équation t(x)=0 définit un hyperplan dans l’espace des attributs.
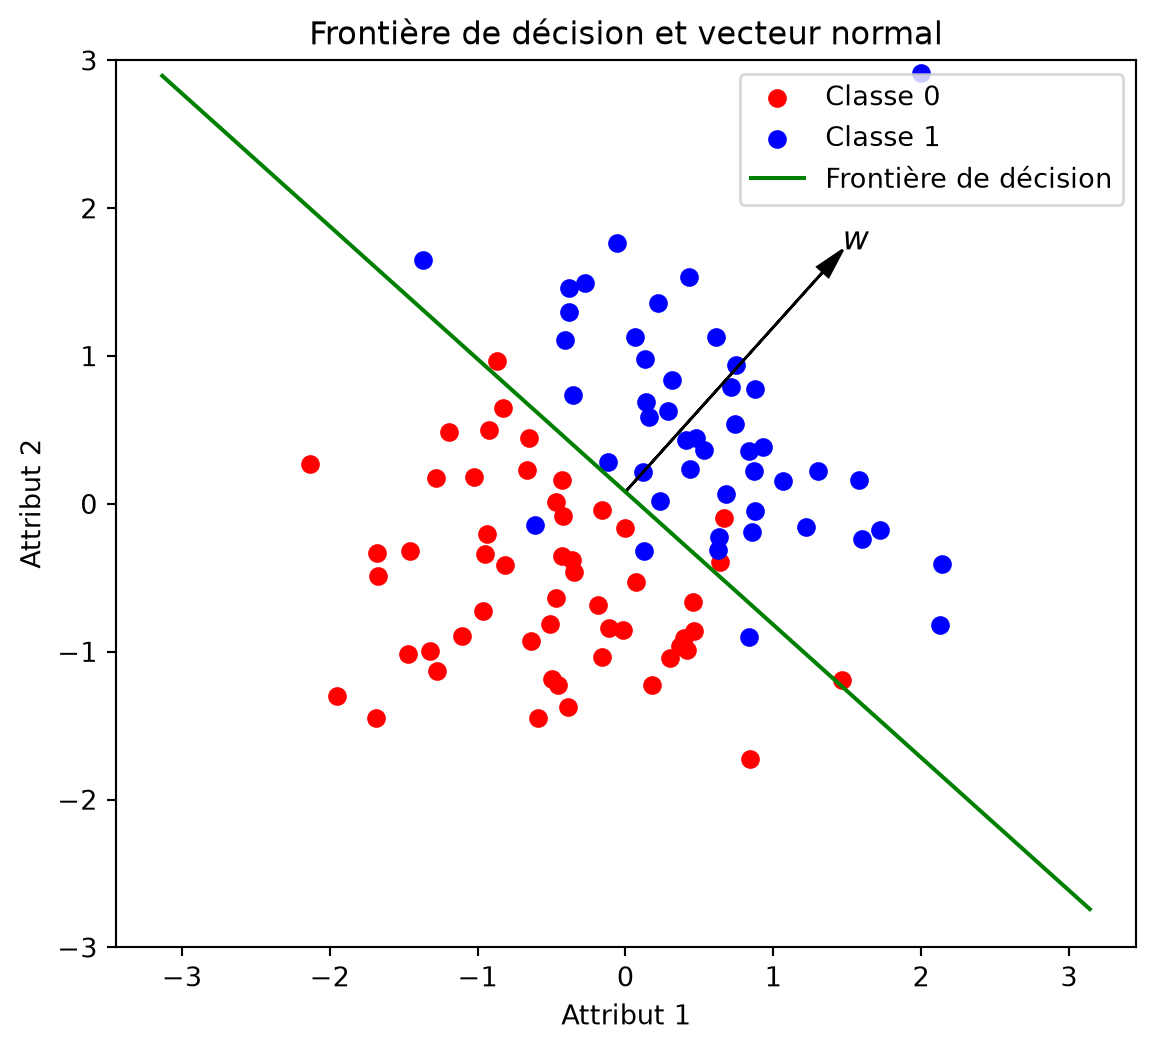
Le vecteur des poids w est normal à cet hyperplan. L’ordonnée à l’origine \theta_0 déplace la frontière sans en modifier l’orientation.
Interprétation géométrique
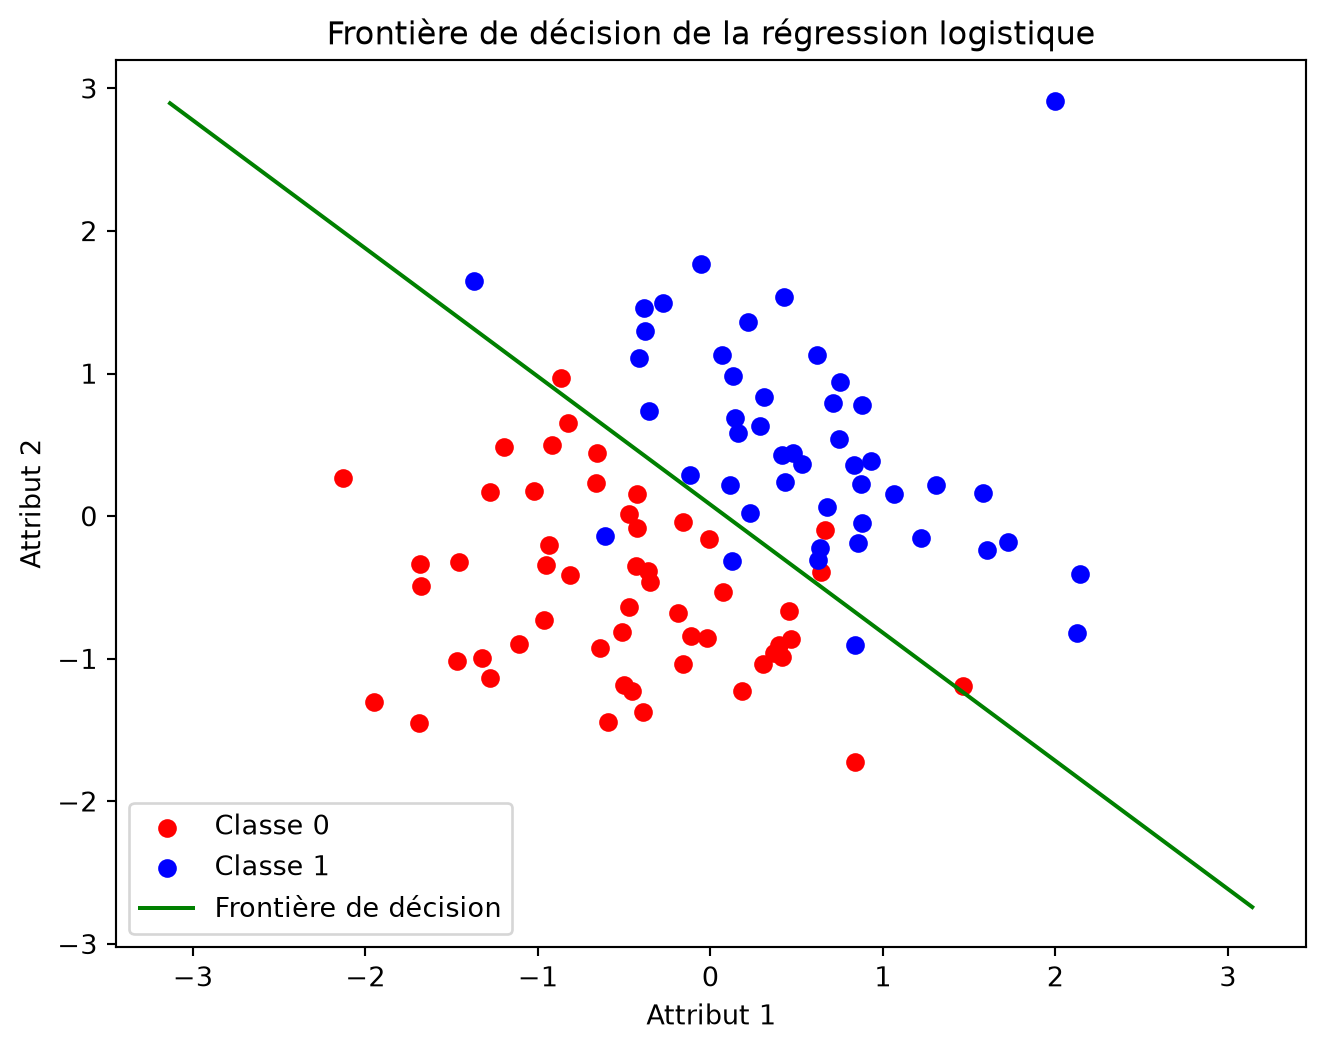
La frontière de décision correspond à t(x)=0.
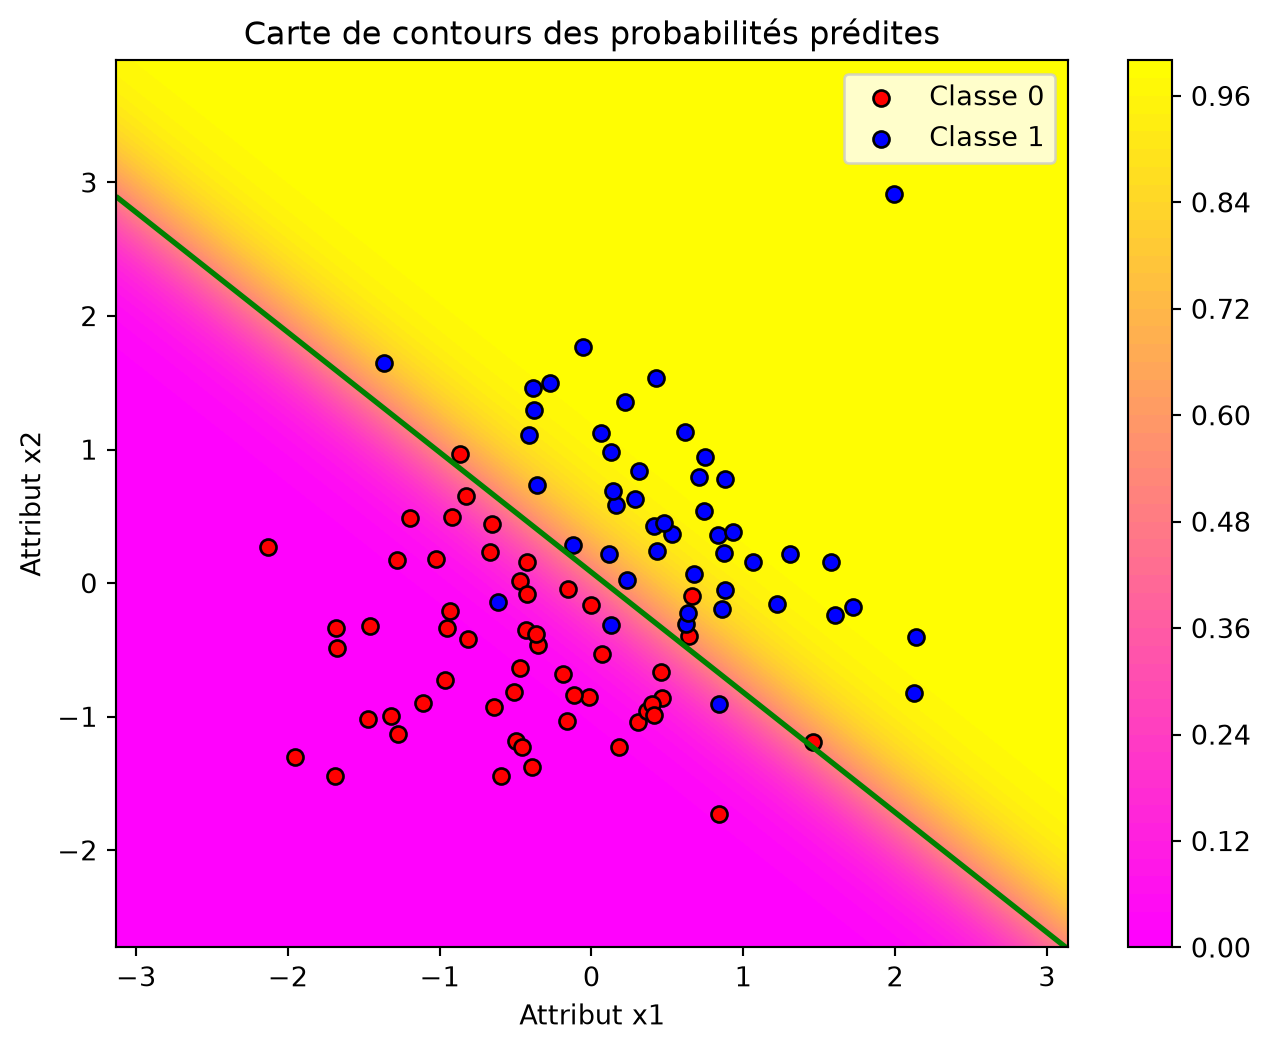
Les points pour lesquels t(x)>0 reçoivent une probabilité supérieure à 0.5.
Les points pour lesquels t(x)<0 reçoivent une probabilité inférieure à 0.5.
La sigmoïde transforme le score linéaire en probabilité. La distance signée à la frontière est
\frac{t(x)}{\|w\|}.
Mise en œuvre
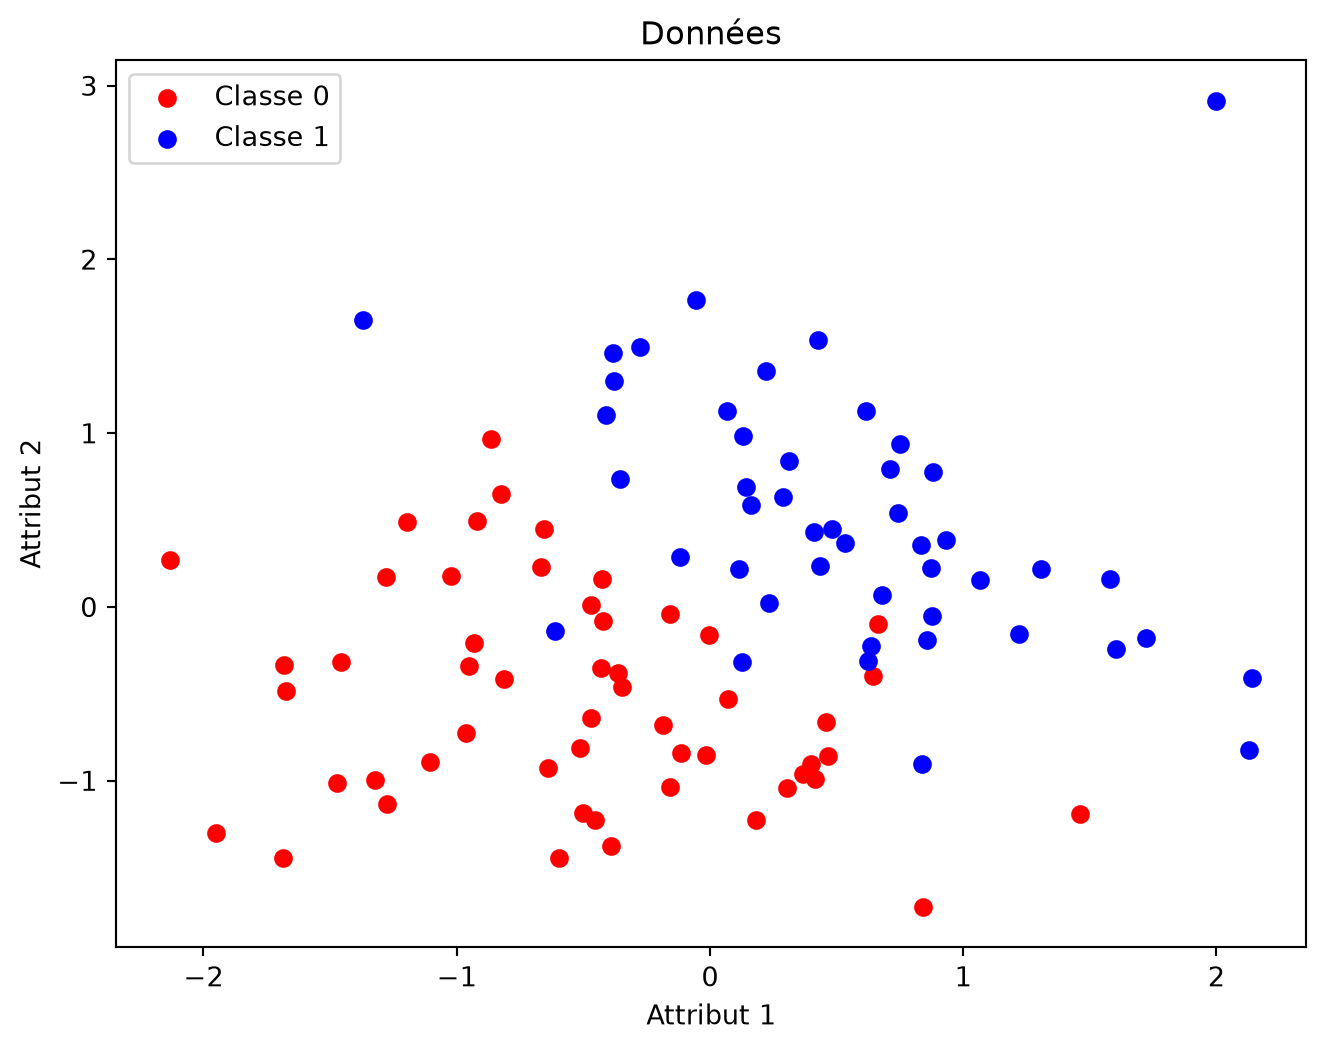
Mise en œuvre : génération des données
# Générer des données synthétiques pour un problème de classification binairem =100# nombre d'exemplesd =2# nombre d'attributsX = rng.standard_normal((m, d))# Définir les étiquettes à l'aide d'une frontière linéaire et d'un peu de bruitnoise =0.5* rng.standard_normal(m)y = (X[:, 0] + X[:, 1] + noise >0).astype(int)
# Fonction de coût : entropie croisée binairedef cost_function(theta, X, y): m =len(y) h = sigmoid(X.dot(theta)) h = np.clip(h, 1e-12, 1-1e-12) cost =-(1/m) * np.sum(y * np.log(h) + (1- y) * np.log(1- h))return cost# Gradient de la fonction de coûtdef gradient(theta, X, y): m =len(y) h = sigmoid(X.dot(theta)) grad = (1/m) * X.T.dot(h - y)return grad
Mise en œuvre : régression logistique
# Entraînement de la régression logistique par descente de gradientdef logistic_regression(X, y, learning_rate=0.1, iterations=1000): m, n = X.shape theta = np.zeros(n) cost_history = []for i inrange(iterations): theta -= learning_rate * gradient(theta, X, y) cost_history.append(cost_function(theta, X, y))return theta, cost_history
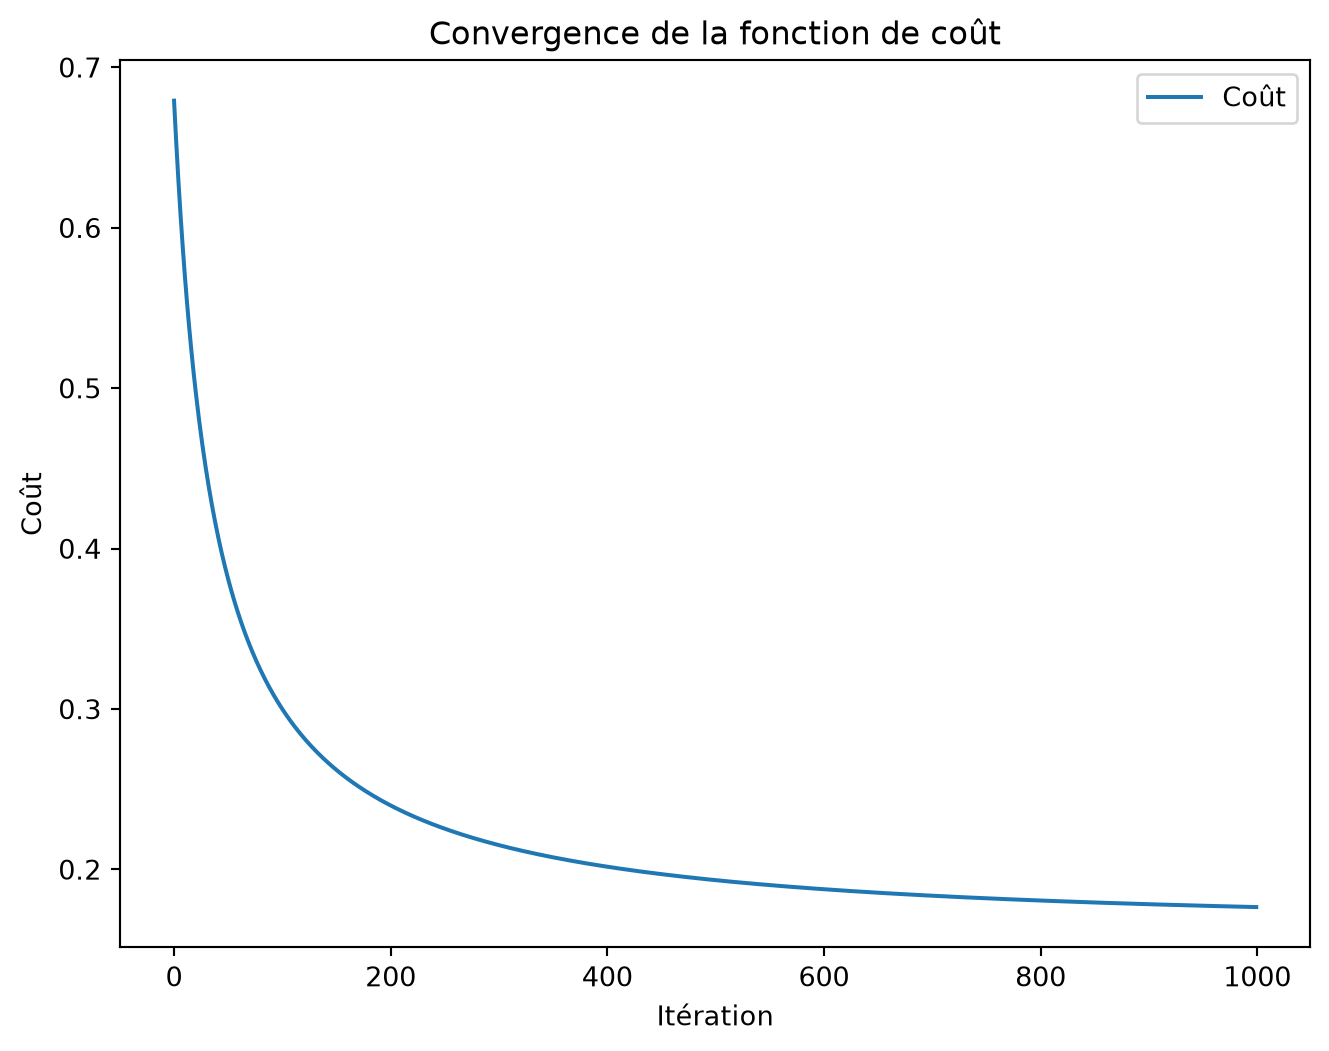
Entraînement
# Ajouter le terme constant (biais)X_with_intercept = np.hstack([np.ones((m, 1)), X])# Entraîner le modèle de régression logistiquetheta, cost_history = logistic_regression(X_with_intercept, y, learning_rate=0.1, iterations=1000)theta_0 = theta[0]w = theta[1:]print("Theta optimisé :", theta)
plt.figure(figsize=(8, 6))plt.plot(cost_history, label="Coût")plt.xlabel("Itération")plt.ylabel("Coût")plt.title("Convergence de la fonction de coût")plt.legend()plt.show()
Le vecteur ajusté des poids des attributs w=(\theta_1,\theta_2)^\top est normal à la frontière de décision.
L’ordonnée à l’origine \theta_0 détermine la position de la frontière.
Visualisation du vecteur des poids
Code
# Tracer la frontière de décision et les donnéesplt.figure(figsize=(8, 6))plt.scatter(X[y ==0][:, 0], X[y ==0][:, 1], color='red', label='Classe 0')plt.scatter(X[y ==1][:, 0], X[y ==1][:, 1], color='blue', label='Classe 1')# Frontière de décision : theta_0 + w[0]*x1 + w[1]*x2 = 0x_vals = np.array([min(X[:, 0]) -1, max(X[:, 0]) +1])y_vals =-(theta_0 + w[0] * x_vals) / w[1]plt.plot(x_vals, y_vals, label='Frontière de décision', color='green')# --- Tracer le vecteur normal ---# Le vecteur normal est w.# Choisir un point de référence sur la frontière. Ici, x1 = 0 :x_ref =0y_ref =-theta_0 / w[1]# Copier le vecteur des poids pour l'affichage.normal = w.copy()# Normaliser et redimensionner pour l'affichagenormal_norm = np.linalg.norm(normal)if normal_norm !=0: normal_unit = normal / normal_normelse: normal_unit = normalscale =2# ajuster l'échelle au besoinnormal_display = normal_unit * scale# Tracer une flèche à partir du point de référenceplt.arrow(x_ref, y_ref, normal_display[0], normal_display[1], head_width=0.1, head_length=0.2, fc='black', ec='black')plt.text(x_ref + normal_display[0]*1.1, y_ref + normal_display[1]*1.1, r'$w$', color='black', fontsize=12)plt.xlabel("Attribut 1")plt.ylabel("Attribut 2")plt.title("Frontière de décision et vecteur normal")plt.legend()plt.gca().set_aspect('equal', adjustable='box')plt.ylim(-3, 3)plt.show()
Près de la frontière de décision
Code
# --- Préparation de la visualisation ---# Créer une grille dans l'espace des attributsx1_range = np.linspace(X[:, 0].min()-1, X[:, 0].max()+1, 100)x2_range = np.linspace(X[:, 1].min()-1, X[:, 1].max()+1, 100)xx1, xx2 = np.meshgrid(x1_range, x2_range)# Construire les entrées de la grille (avec l'ordonnée à l'origine)grid = np.c_[np.ones(xx1.ravel().shape), xx1.ravel(), xx2.ravel()]# Calculer les probabilités prédites sur la grilleprobs = sigmoid(grid.dot(theta)).reshape(xx1.shape)# --- Carte de contours en deux dimensions ---plt.figure(figsize=(8, 6))contour = plt.contourf(xx1, xx2, probs, cmap='spring', levels=50)plt.colorbar(contour)plt.contour(xx1, xx2, probs, levels=[0.5], colors='green', linewidths=2)plt.xlabel('Attribut x1')plt.ylabel('Attribut x2')plt.title('Carte de contours des probabilités prédites')# Superposer les données d'entraînementplt.scatter(X[y ==0][:, 0], X[y ==0][:, 1], color='red', edgecolor='k', label='Classe 0')plt.scatter(X[y ==1][:, 0], X[y ==1][:, 1], color='blue', edgecolor='k', label='Classe 1')plt.legend()plt.show()
Épilogue
Sommaire
La régression logistique modélise la probabilité d’un résultat binaire.
Maximiser la vraisemblance de Bernoulli équivaut à minimiser l’entropie croisée binaire.
L’entropie croisée pénalise fortement les prédictions incorrectes faites avec confiance.
L’équation \theta_0+w^\top x=0 définit la frontière de décision, et le vecteur des poids w lui est normal.
La descente de gradient par lot met à jour les paramètres à partir du gradient moyen sur l’ensemble d’entraînement.
Prochain cours
Mesures de performance et évaluation des modèles
Références
Russell, Stuart, et Peter Norvig. 2020. Artificial Intelligence: A Modern Approach. 4ᵉ éd. Pearson. http://aima.cs.berkeley.edu/.