import pandas as pd

WOLFRAM_CSV = "https://raw.githubusercontent.com/turcotte/csi4106-f26/refs/heads/main/datasets/old_faithful_eruptions/Sample-Data-Old-Faithful-Eruptions.csv"
df = pd.read_csv(WOLFRAM_CSV)

# Renommer les colonnes
df = df.rename(columns={"Duration": "eruptions", "WaitingTime": "waiting"})
print(df.shape)
df.head(6)Régression linéaire et descente de gradient
CSI 4506 - automne 2026
Marcel Turcotte
Version : 23 septembre 2026 07h51
Préambule
Message du jour
Objectifs d’apprentissage
- Reconnaître la régression comme une tâche d’apprentissage supervisé dont l’étiquette est une valeur réelle.
- Définir une hypothèse linéaire et son objectif d’erreur quadratique moyenne.
- Distinguer l’espace des paramètres de l’espace des hypothèses, et expliquer comment un vecteur de paramètres détermine une hypothèse.
- Expliquer comment le gradient et le taux d’apprentissage déterminent une mise à jour par descente de gradient.
- Expliquer l’importance de la convexité dans l’optimisation d’un modèle de régression linéaire.
- Comparer les descentes de gradient par lot, stochastique et par mini-lots.
Régression linéaire
Justification
La régression linéaire est introduite pour présenter de manière pratique un algorithme d’apprentissage bien connu, la descente de gradient. De plus, elle sert de base pour introduire la régression logistique – un algorithme de classification – qui facilite davantage les discussions sur les réseaux de neurones artificiels.
- Régression linéaire
- Descente de gradient
- Régression logistique
- Réseaux de neurones
Apprentissage supervisé - régression
- Les données d’entraînement sont une collection d’exemples étiquetés.
- \{(x_i,y_i)\}_{i=1}^N
- Chaque x_i est un vecteur d’attributs avec D dimensions.
- x_i^{(j)} est la valeur de l’attribut j de l’exemple i, pour j \in 1 \ldots D et i \in 1 \ldots N.
- L’étiquette y_i est un nombre réel.
- \{(x_i,y_i)\}_{i=1}^N
- Problème : Étant donné l’ensemble de données en entrée, créer un modèle pouvant être utilisé pour prédire la valeur de y pour un x non vu.
Éruptions du Old Faithful
Éruptions du Old Faithful
(272, 2)| eruptions | waiting | |
|---|---|---|
| 0 | 3.600 | 79 |
| 1 | 1.800 | 54 |
| 2 | 3.333 | 74 |
| 3 | 2.283 | 62 |
| 4 | 4.533 | 85 |
| 5 | 2.883 | 55 |
Geyser Old Faithful
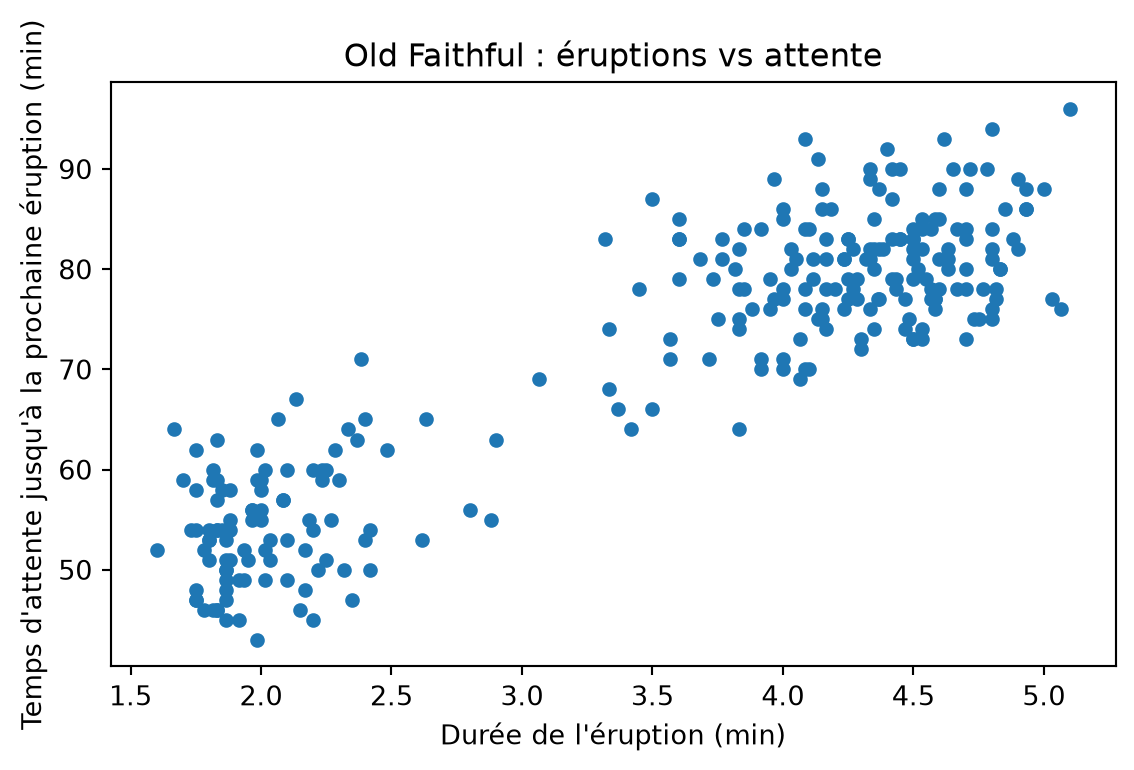
Visualisation rapide
Problème
- Prédire le temps d’attente jusqu’à la prochaine éruption, y, en fonction de la durée de l’éruption actuelle, x.
Régression linéaire
Un modèle linéaire suppose que la valeur de l’étiquette, \hat{y_i}, peut être exprimée comme une combinaison linéaire des valeurs des attributs, x_i^{(j)} : \hat{y_i} = \theta_0 + \theta_1 x_i^{(1)} + \theta_2 x_i^{(2)} + \ldots + \theta_D x_i^{(D)}
Ici, \theta_{j} est le j-ième paramètre du modèle (linéaire), avec \theta_0 étant le terme/paramètre de biais, et \theta_1 \ldots \theta_D étant les poids des attributs.
Définition
Problème : trouver les valeurs de tous les paramètres afin que le modèle s’ajuste au mieux aux données d’entraînement.
- L’erreur quadratique moyenne (EQM) est un objectif courant pour les problèmes de régression.
J(\theta) = \frac{1}{N}\sum_{i=1}^N [h_\theta(x_i) - y_i]^2
Minimisation de l’EQM

Apprentissage
Code
from sklearn.linear_model import LinearRegression, SGDRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score

# Préparer les données
X = df[["eruptions"]].values  # shape (n_samples, 1)
y = df["waiting"].values      # shape (n_samples,)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# Ajuster via SGDRegressor — modèle linéaire via descente de gradient
sgd = SGDRegressor(
    loss="squared_error",
    penalty=None,
    learning_rate="constant",
    eta0=0.01,  # Taux d'apprentissage initial (alpha dans notre notation).
    max_iter=2000,
    tol=None,
    random_state=42
)

sgd.fit(X_train, y_train)

print("Paramètres appris :")
print(f"  intercept = {sgd.intercept_[0]:.3f}")
print(f"  pente     = {sgd.coef_[0]:.3f}")

y_pred = sgd.predict(X_test)
print(f"MSE test = {mean_squared_error(y_test, y_pred):.2f}")
print(f"R² test  = {r2_score(y_test, y_pred):.3f}")
Paramètres appris :
intercept = 32.910
pente = 10.503
MSE test = 43.02
R² test = 0.671Visualisation
Code
import numpy as np

# Disperser les données
plt.figure(figsize=(6,4))
plt.scatter(X, y, color="steelblue", s=30, alpha=0.7, label="données")

# Tracer la ligne ajustée
x_line = np.linspace(0, X.max(), 100).reshape(-1, 1)
y_line = sgd.predict(x_line)
plt.plot(x_line, y_line, color="red", linewidth=2, label="ligne ajustée")

plt.xlabel("Durée de l'éruption (min)")
plt.ylabel("Temps d'attente jusqu'à la prochaine éruption (min)")
plt.title("Old Faithful : Régression linéaire via SGD")
plt.legend()
plt.tight_layout()
plt.show()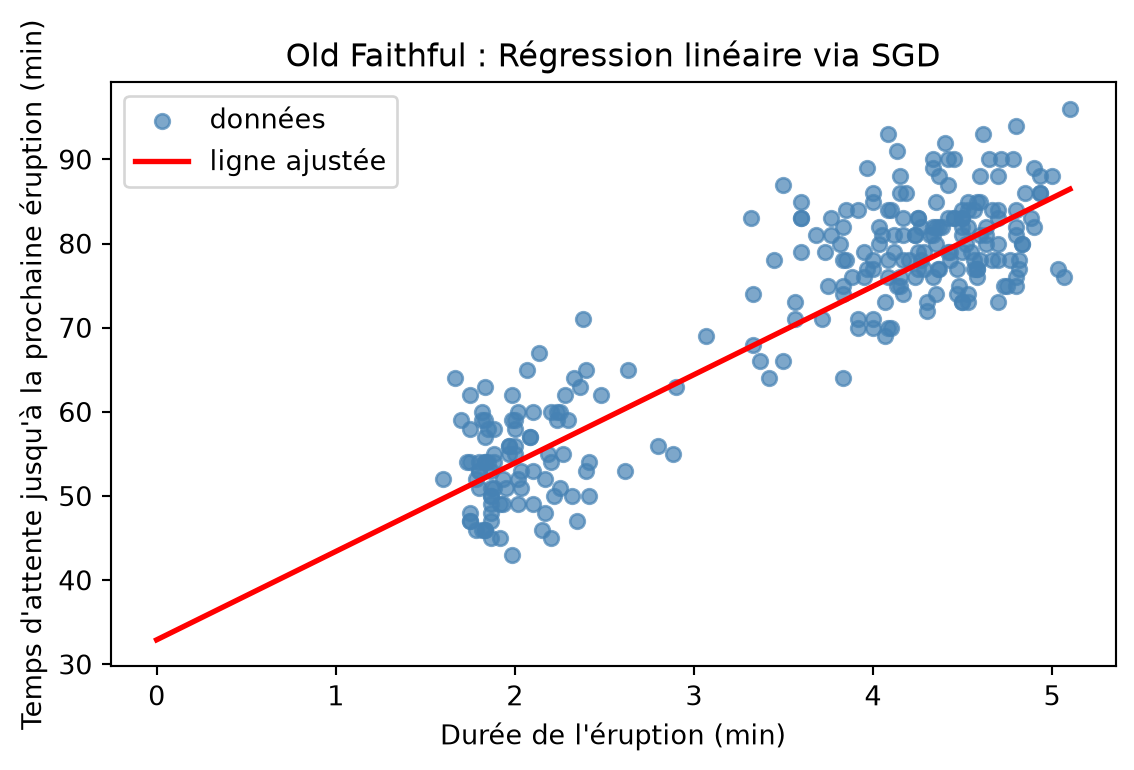
Caractéristiques
Un algorithme d’apprentissage typique comprend les composants suivants :
- Un modèle, souvent composé d’un ensemble de paramètres dont les valeurs seront “apprises”.
- Une fonction objectif qui mesure l’erreur de prédiction sur les données d’entraînement.
- L’erreur quadratique moyenne est un objectif courant pour les problèmes de régression. \frac{1}{N}\sum_{i=1}^N [h_\theta(x_i) - y_i]^2
- Un algorithme d’optimisation.
Optimisation
Jusqu’à ce que certains critères d’arrêt soient atteints1 :
- Évaluer la fonction de perte, en comparant h(x_i) à y_i.
- Apporter de petites modifications aux poids, de manière à réduire la valeur de la fonction de perte.
Remarques
- Il est important de séparer l’algorithme d’optimisation du problème qu’il traite.
- Pour la régression linéaire, une solution analytique exacte existe, mais elle présente certaines limitations.
- La descente de gradient sert d’algorithme général applicable non seulement à la régression linéaire, mais aussi à la régression logistique, l’apprentissage profond, t-SNE (t-distributed Stochastic Neighbor Embedding), parmi divers autres problèmes.
- Il existe une gamme diversifiée d’algorithmes d’optimisation qui ne reposent pas sur des méthodes basées sur le gradient.
Optimisation — un attribut
Modèle (hypothèse) :
h(x_i; \theta) = \theta_0 + \theta_1 x_i^{(1)}Fonction de perte/coût :
J(\theta_0, \theta_1) = \frac{1}{N}\sum_{i=1}^N [h(x_i;\theta) - y_i]^2
Hypothèses et espace des paramètres
Code
# L'objectif est défini sur le jeu de données complet et fixe.
x = X.squeeze().astype(float)
y = y.astype(float)

# Erreur quadratique moyenne J.
def mse(theta0, theta1, x, y):
    yhat = theta0 + theta1 * x
    return np.mean((y - yhat) ** 2)

# Minimum exact des moindres carrés sur le jeu de données complet.
full_data_model = LinearRegression().fit(X, y)
theta_star = np.array([
    full_data_model.intercept_,
    full_data_model.coef_[0],
])

# Grille pour θ0∈[0,100] et θ1∈[0,20].
t0_vals = np.linspace(0, 100, 200)
t1_vals = np.linspace(0, 20, 200)
T0, T1 = np.meshgrid(t0_vals, t1_vals)

J = np.empty_like(T0, dtype=float)
for i in range(T0.shape[0]):
    for j in range(T0.shape[1]):
        J[i, j] = mse(T0[i, j], T1[i, j], x, y)

# Séquence illustrative de paramètres qui se termine au minimum.
traj = np.array([
    (0.000,   0.000),
    (10.000,  2.000),
    (20.000,  4.000),
    (30.000,  7.000),
    theta_star,
])
traj_J = np.array([mse(t0, t1, x, y) for (t0, t1) in traj])

# À gauche : hypothèses choisies. À droite : leurs valeurs dans l'espace des paramètres.
fig = plt.figure(figsize=(12, 4.8))

# Panneau de gauche : hypothèses dans l'espace entrée-sortie
ax1 = fig.add_subplot(1, 2, 1)
order = np.argsort(x)
ax1.scatter(x, y, s=18, alpha=0.75, label="données")
ax1.axhline(y.mean(), color="gray", ls="--", lw=1, label=r"$\bar y$")
for k, (t0, t1) in enumerate(traj):
    yline = t0 + t1 * x
    ax1.plot(
        x[order], yline[order],
        lw=2 if k == len(traj) - 1 else 1.2,
        alpha=1.0 if k == len(traj) - 1 else 0.85,
        label=fr"$\theta_0={t0:.3f},\ \theta_1={t1:.3f}$"
    )
ax1.set_xlabel("Durée de l'éruption (min)")
ax1.set_ylabel("Temps d'attente jusqu'à la prochaine éruption (min)")
ax1.set_title("Hypothèses choisies dans l'espace entrée-sortie")
ax1.legend(fontsize=8, loc="best")

# Panneau de droite : objectif dans l'espace des paramètres
ax2 = fig.add_subplot(1, 2, 2, projection='3d')

vmin = np.percentile(J, 5)
vmax = np.percentile(J, 95)

surf = ax2.plot_surface(
    T0, T1, J, rstride=3, cstride=3,
    cmap="viridis", linewidth=0, antialiased=False,
    vmin=vmin, vmax=vmax, alpha=0.6
)

# Superposer la séquence illustrative.
ax2.plot(traj[:,0], traj[:,1], traj_J, color='crimson', marker='o', lw=2, label="séquence illustrative")

ax2.set_xlabel(r'$\theta_0$')
ax2.set_ylabel(r'$\theta_1$')
ax2.set_zlabel(r'$J(\theta)$ (EQM)')
ax2.set_title("Objectif dans l'espace des paramètres")
ax2.legend(loc="best", fontsize=8)

ax2.view_init(elev=30, azim=-60)

fig.colorbar(surf, ax=ax2, shrink=0.7, pad=0.05, label="EQM")
plt.tight_layout()
plt.show()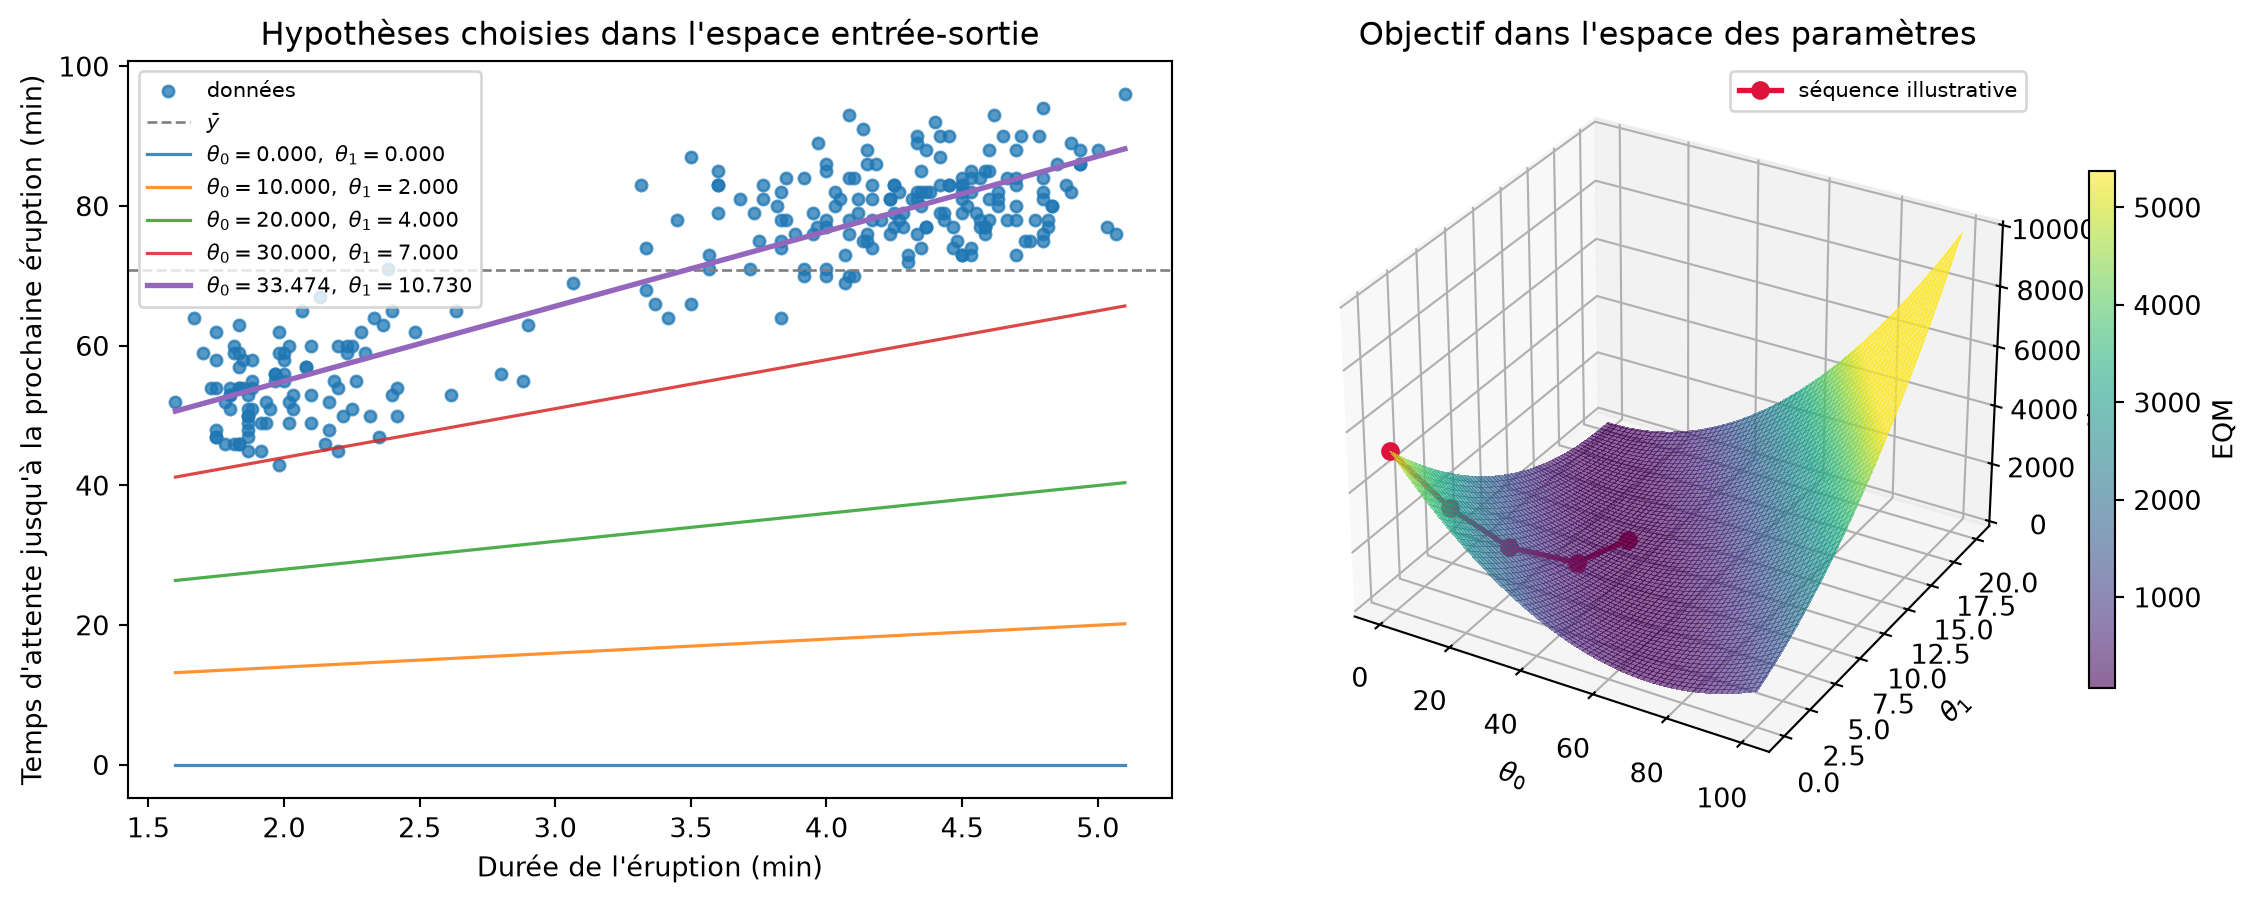
Hypothèses et espace des paramètres
Code
# Réutiliser le même jeu de données, le même objectif, la même grille
# et la même séquence de paramètres.
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4.5))

# Gauche : données + les lignes spécifiées
order = np.argsort(x)
ax1.scatter(x, y, s=18, alpha=0.75, label="données")
for k, (t0, t1) in enumerate(traj):
    yline = t0 + t1 * x
    ax1.plot(x[order], yline[order], lw=2 if k == len(traj) - 1 else 1.2,
             alpha=1.0 if k == len(traj) - 1 else 0.8,
             label=fr"$\theta_0={t0:.3f},\ \theta_1={t1:.3f}$")
ax1.axhline(y.mean(), color="gray", ls="--", lw=1, label=r"$\bar y$")
ax1.set_xlabel("Durée de l'éruption (min)")
ax1.set_ylabel("Temps d'attente jusqu'à la prochaine éruption (min)")
ax1.set_title("Hypothèses choisies dans l'espace entrée-sortie")
ax1.legend(fontsize=8, loc="best")

# Montrer le même objectif dans l'espace des paramètres sous forme de contours.
cs = ax2.contour(T0, T1, J, levels=30)
ax2.clabel(cs, inline=True, fontsize=8)
ax2.plot(traj[:,0], traj[:,1], 'r-o', lw=2, ms=4, label="séquence illustrative")
for (t0, t1, jval) in zip(traj[:,0], traj[:,1], traj_J):
    ax2.annotate(f"{jval:.1f}", (t0, t1), textcoords="offset points",
                 xytext=(4,4), fontsize=8)
ax2.set_xlim(0, 100); ax2.set_ylim(0, 20)
ax2.set_xlabel(r'$\theta_0$'); ax2.set_ylabel(r'$\theta_1$')
ax2.set_title("Contours de l'objectif dans l'espace des paramètres")
ax2.legend(loc="best", fontsize=8)

plt.tight_layout()
plt.show()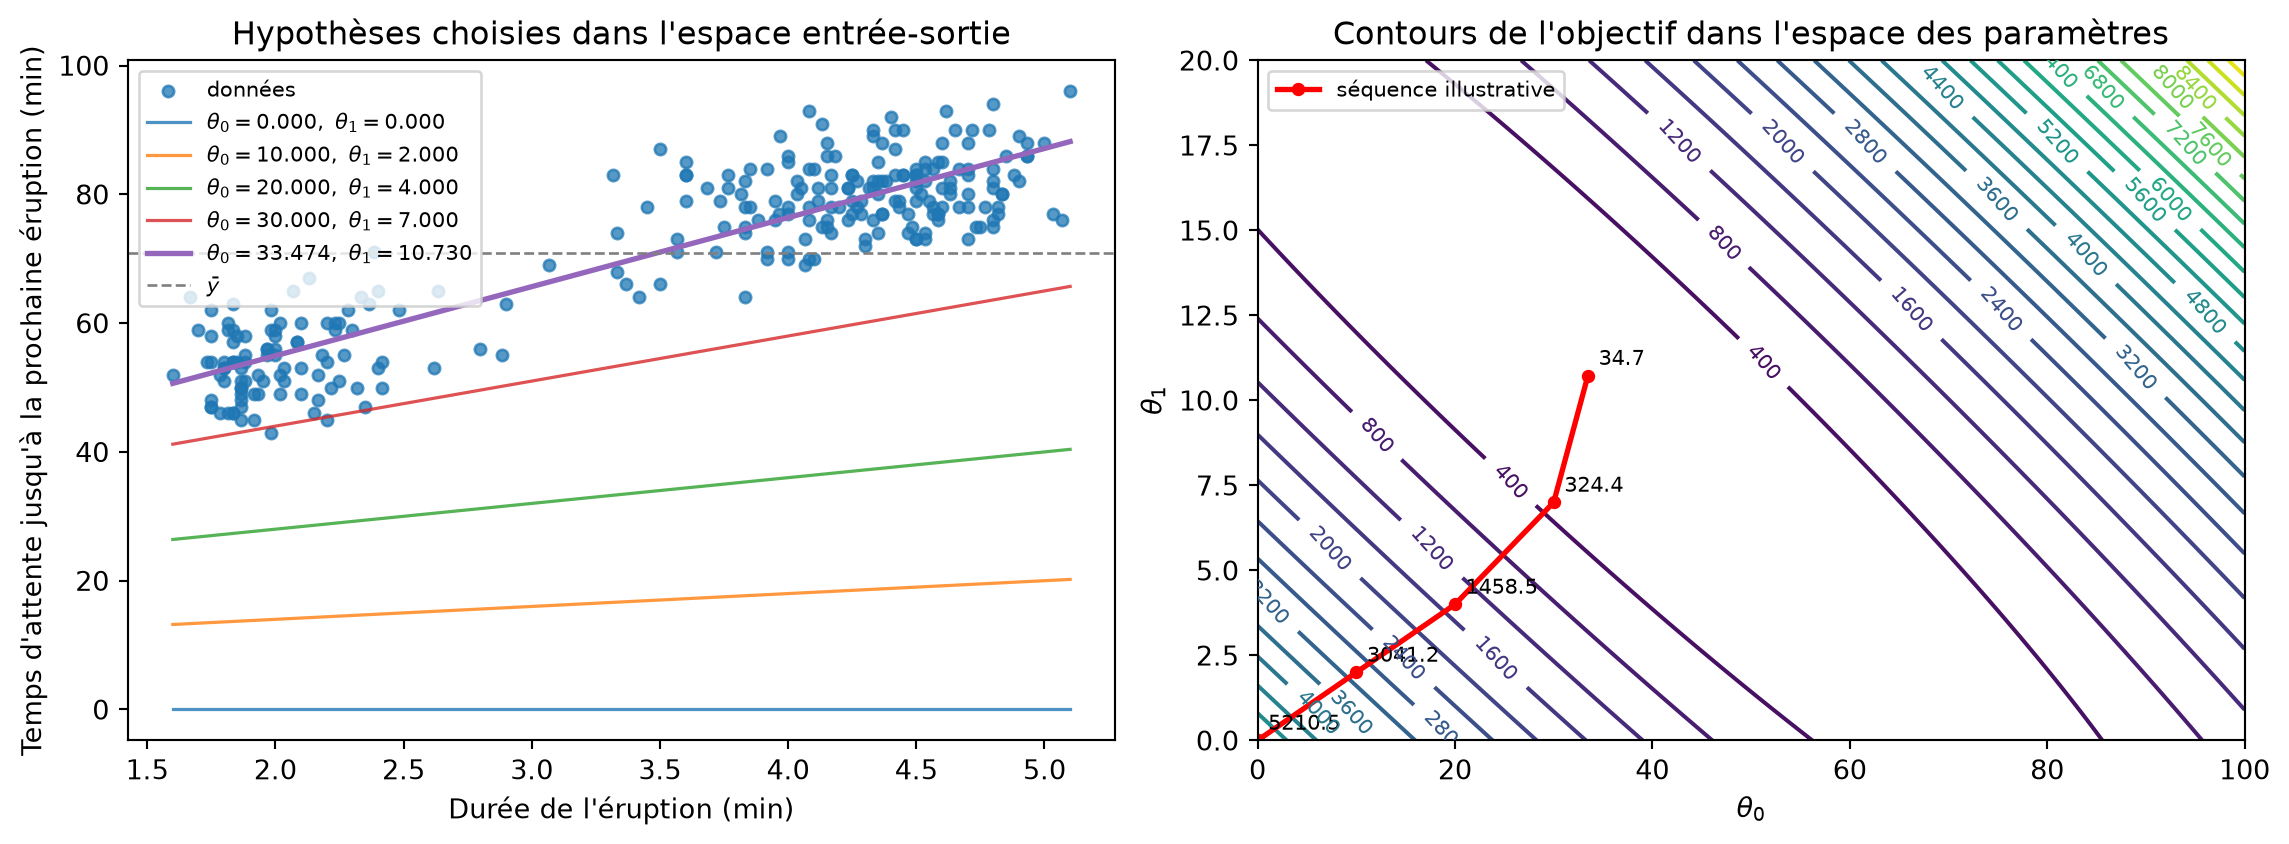
Dérivée
Dérivée
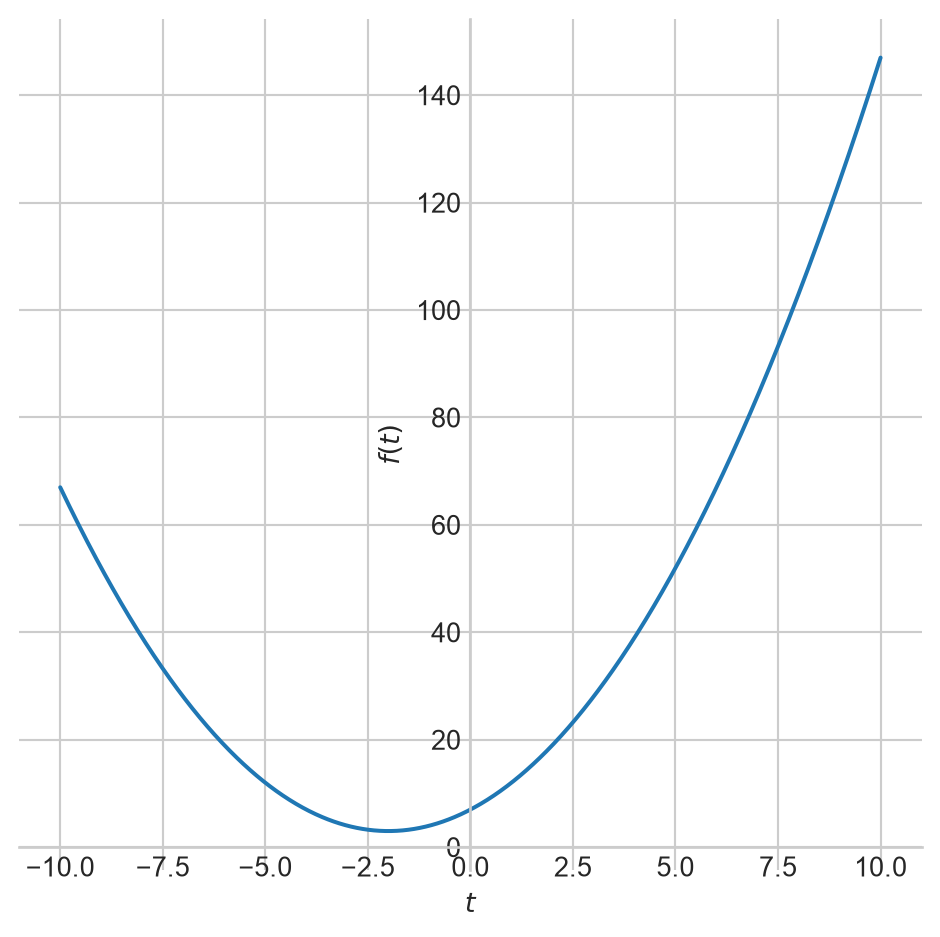
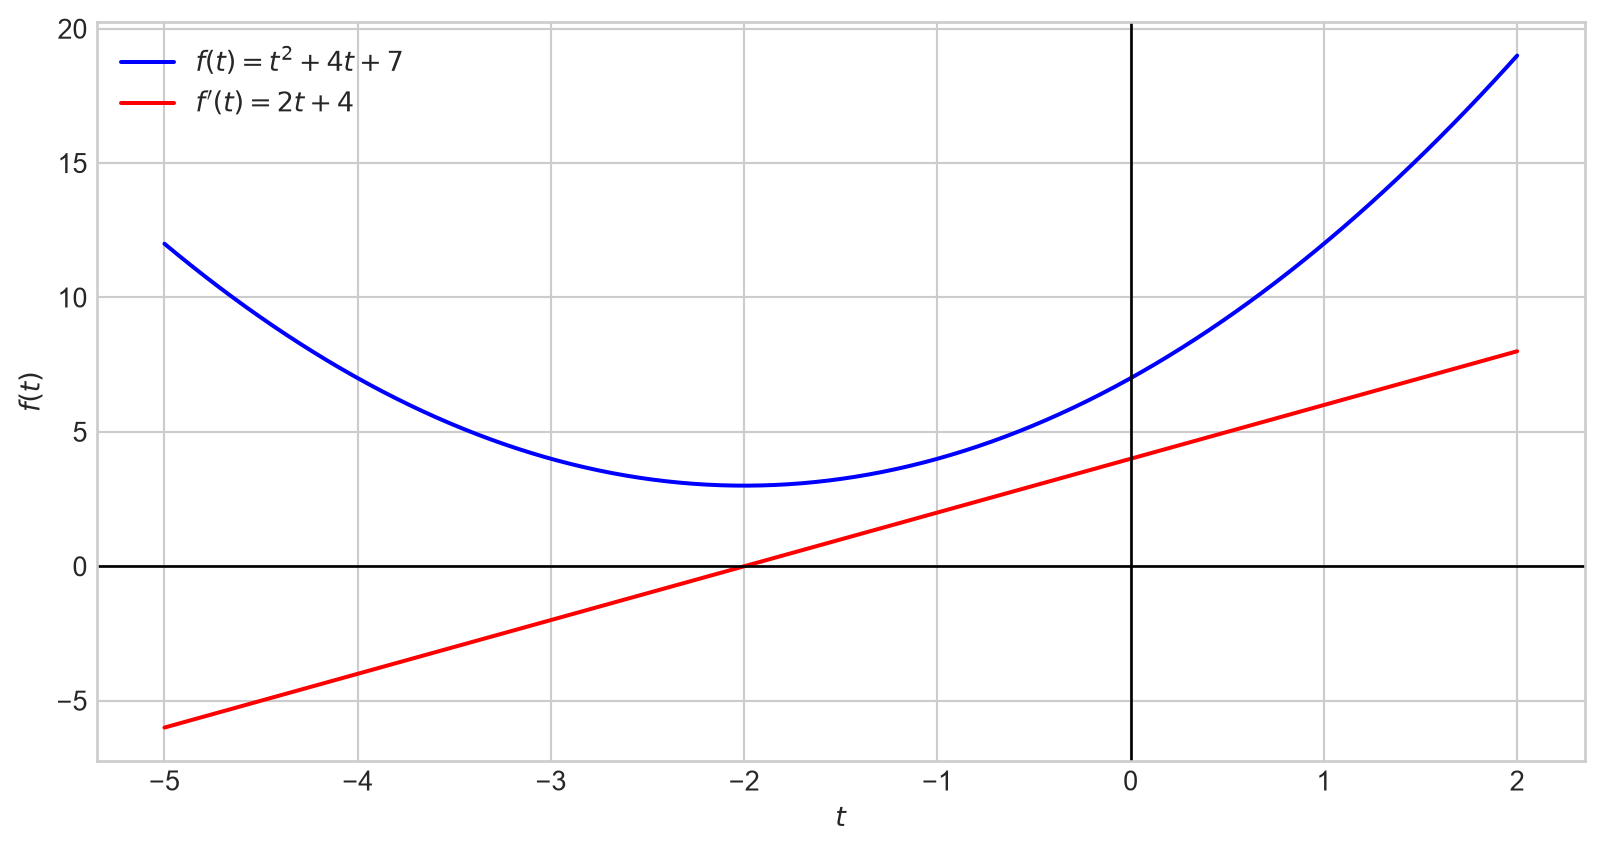
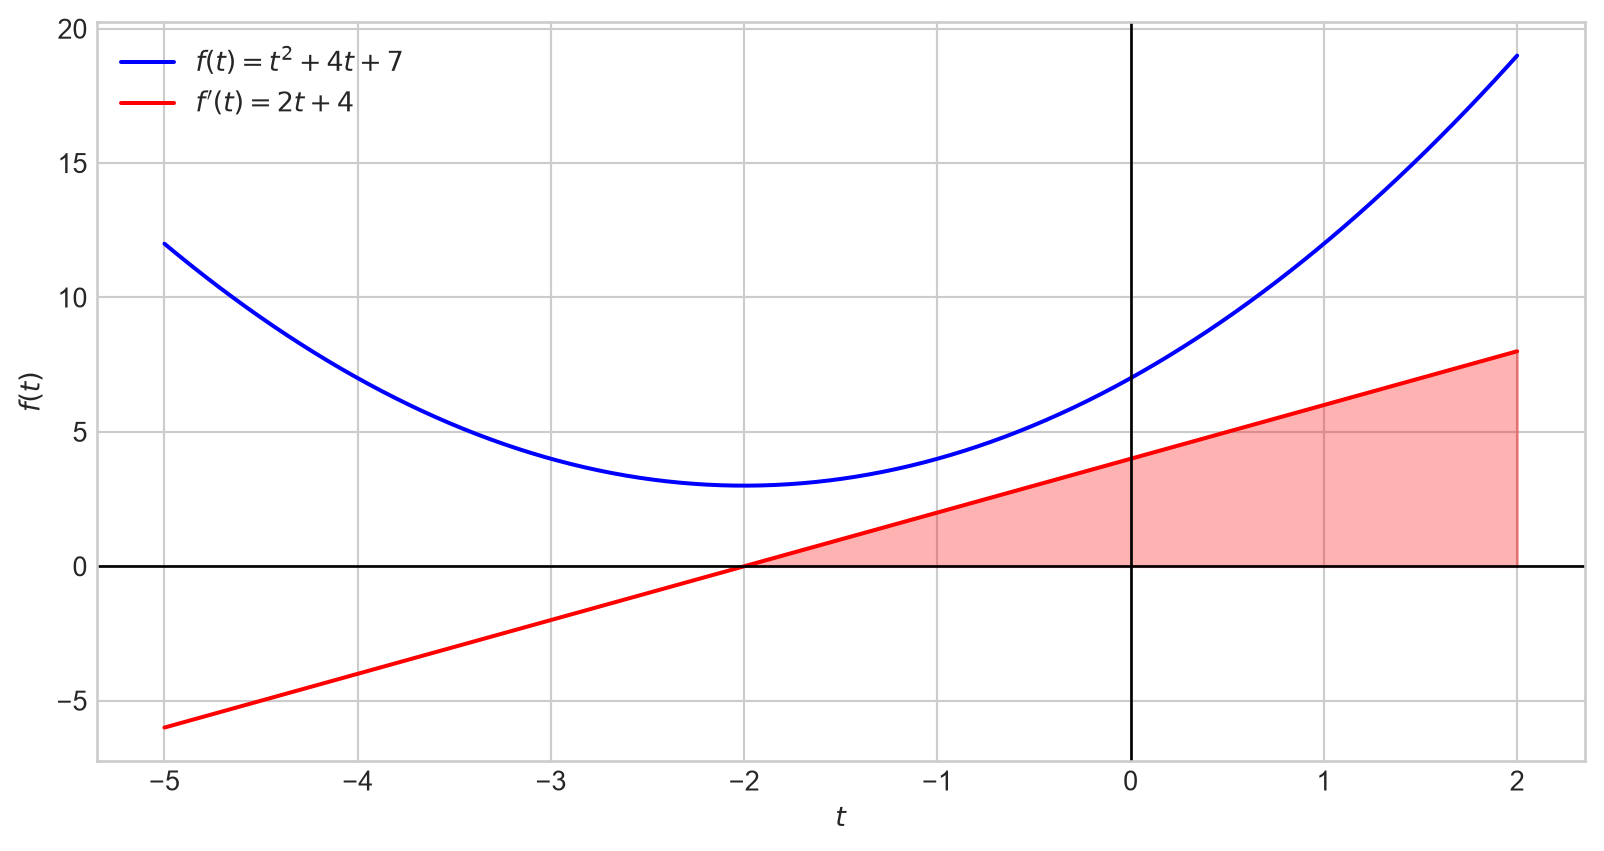
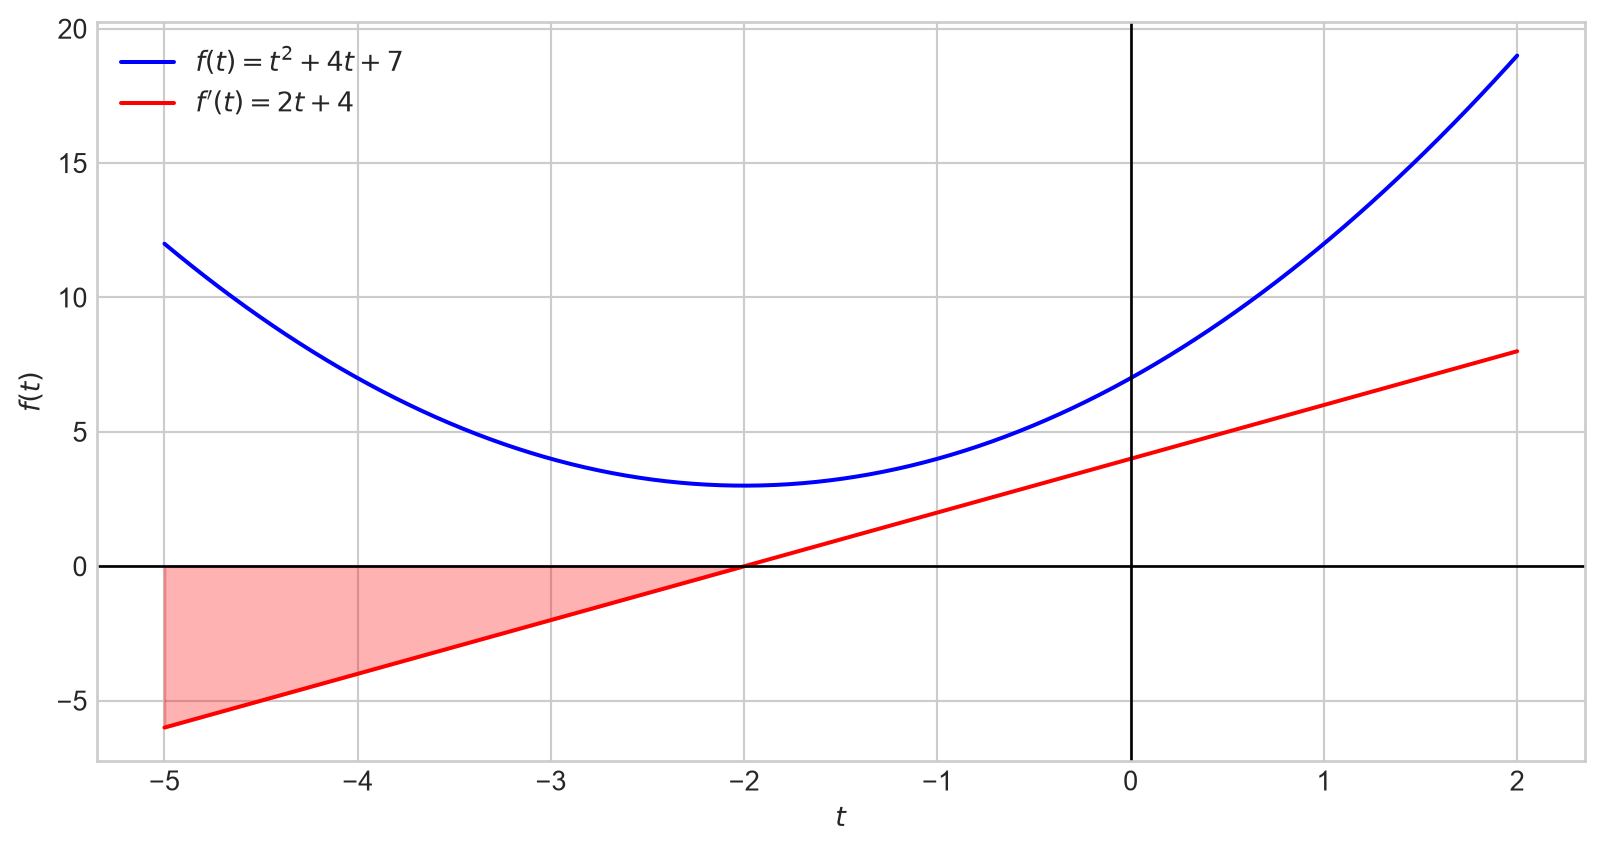
- Nous commencerons par une fonction à une variable.
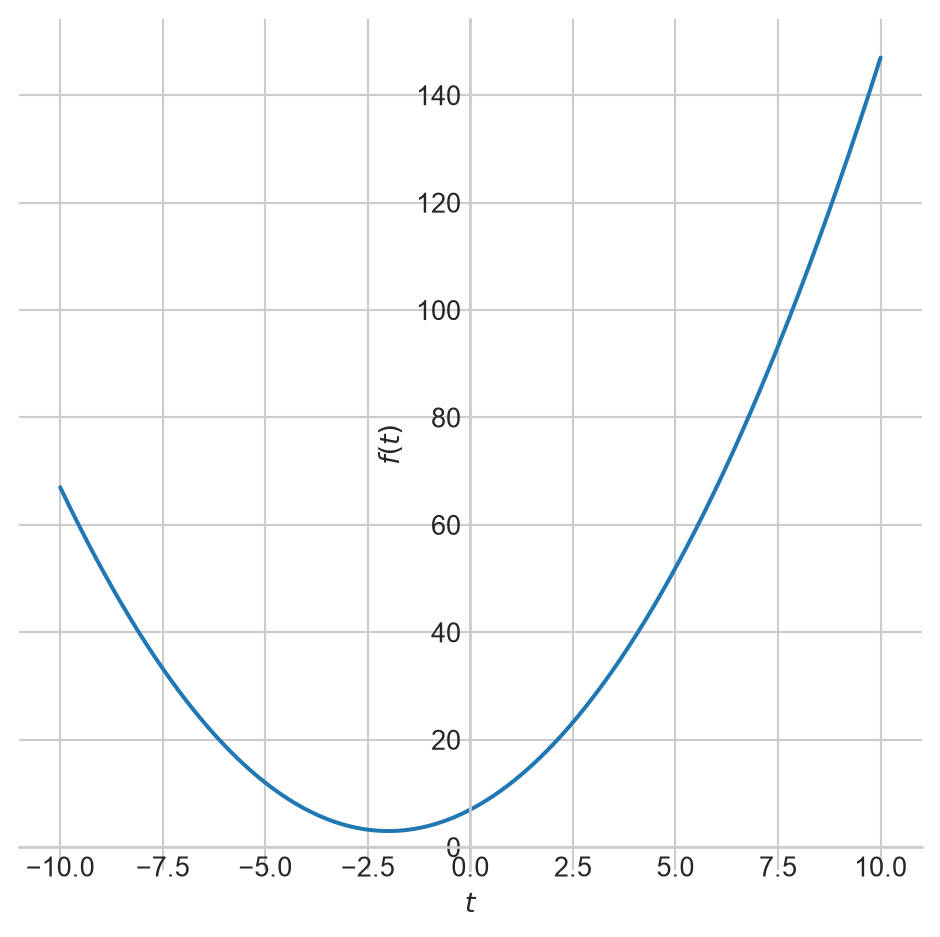
- Considérez cela comme notre fonction de perte, que nous visons à minimiser; pour réduire la disparité moyenne entre les valeurs attendues et les valeurs prédites.
- J’utilise le symbol t pour la variable afin d’éviter toute confusion avec les attributs des exemples de notre jeu de données.
Code source
Code
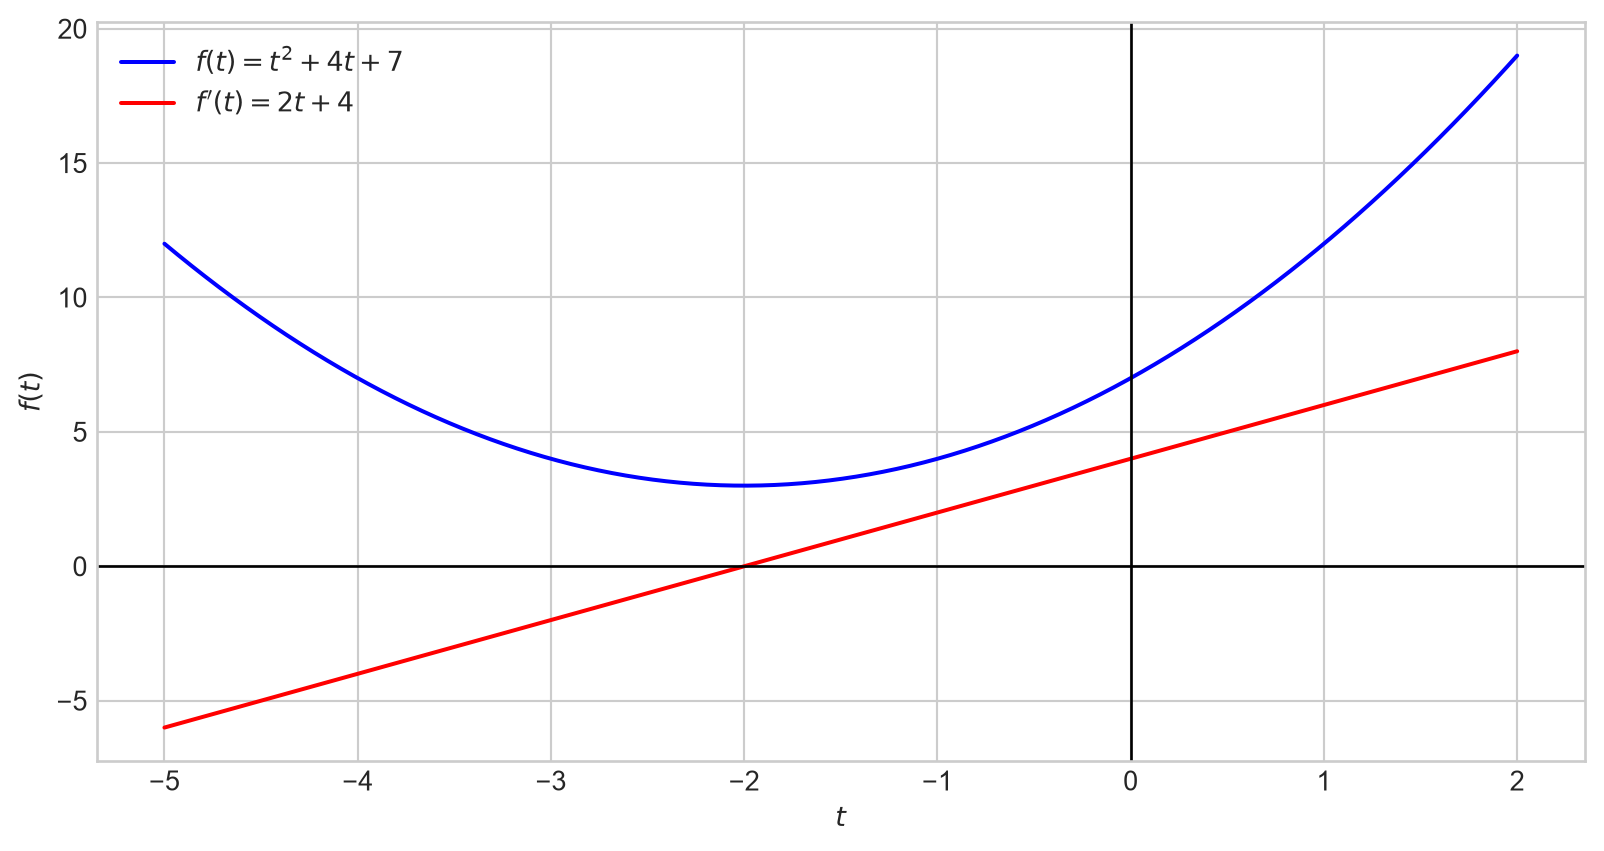
quadratic_derivative = sp.diff(quadratic_expression, t)
quadratic_function = sp.lambdify(t, quadratic_expression, "numpy")
derivative_function = sp.lambdify(t, quadratic_derivative, "numpy")
t_values = np.linspace(-5, 2, 400)

def plot_quadratic_and_derivative(shade=None, objective=False):
    function_values = quadratic_function(t_values)
    derivative_values = derivative_function(t_values)
    function_label = r"$J$" if objective else r"$f(t) = t^2 + 4t + 7$"
    derivative_label = (
        r"$\frac{\partial J}{\partial \theta_j}$"
        if objective else r"$f'(t) = 2t + 4$"
    )

    plt.plot(t_values, function_values, label=function_label, color="blue")
    plt.plot(t_values, derivative_values, label=derivative_label, color="red")
    if shade == "positive":
        plt.fill_between(
            t_values, derivative_values,
            where=(derivative_values > 0), color="red", alpha=0.3,
        )
    elif shade == "negative":
        plt.fill_between(
            t_values, derivative_values,
            where=(derivative_values < 0), color="red", alpha=0.3,
        )

    plt.axhline(0, color="black", linewidth=1)
    plt.axvline(0, color="black", linewidth=1)
    plt.xlabel(r"$\theta_j$" if objective else "$t$")
    plt.ylabel("$J$" if objective else "$f(t)$")
    plt.legend()
    plt.grid(True)
plt.show()Dérivée
Dérivée
Dérivée
Dérivée
Code source
Descente de gradient
Descente de gradient — un attribut
Modèle (hypothèse) :
h(x_i; \theta) = \theta_0 + \theta_1 x_i^{(1)}Fonction de perte/coût :
J(\theta_0, \theta_1) = \frac{1}{N}\sum_{i=1}^N [h(x_i;\theta) - y_i]^2
Descente de gradient - intuition
Descente de gradient - étape par étape
Descente de gradient - une variable
- Initialisation : \theta_0 et \theta_1 - soit avec des valeurs aléatoires, soit avec des zéros.
- Boucle :
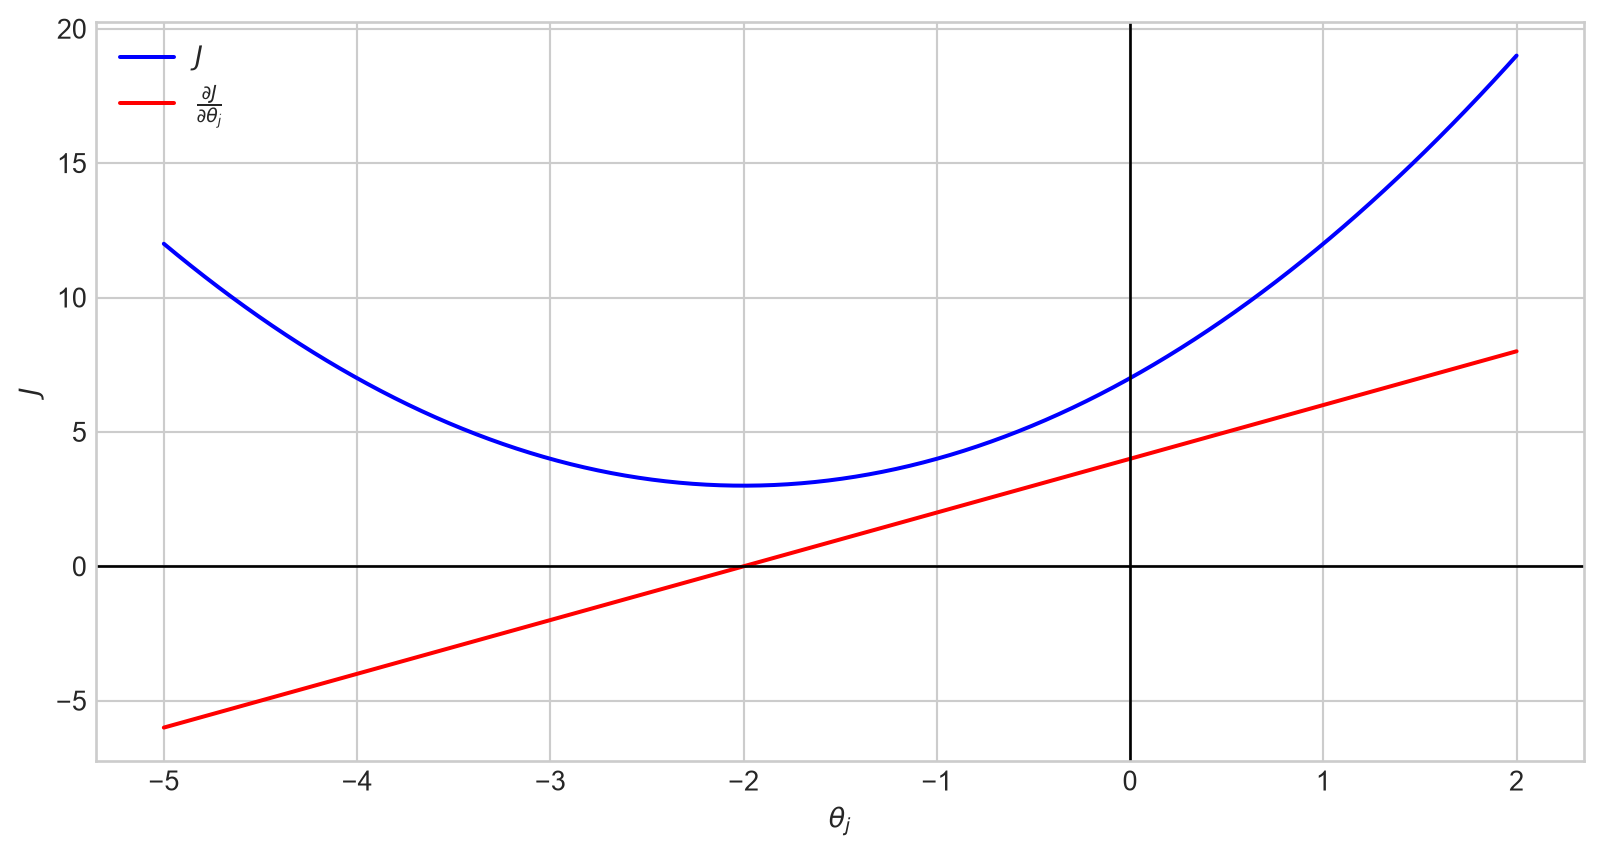
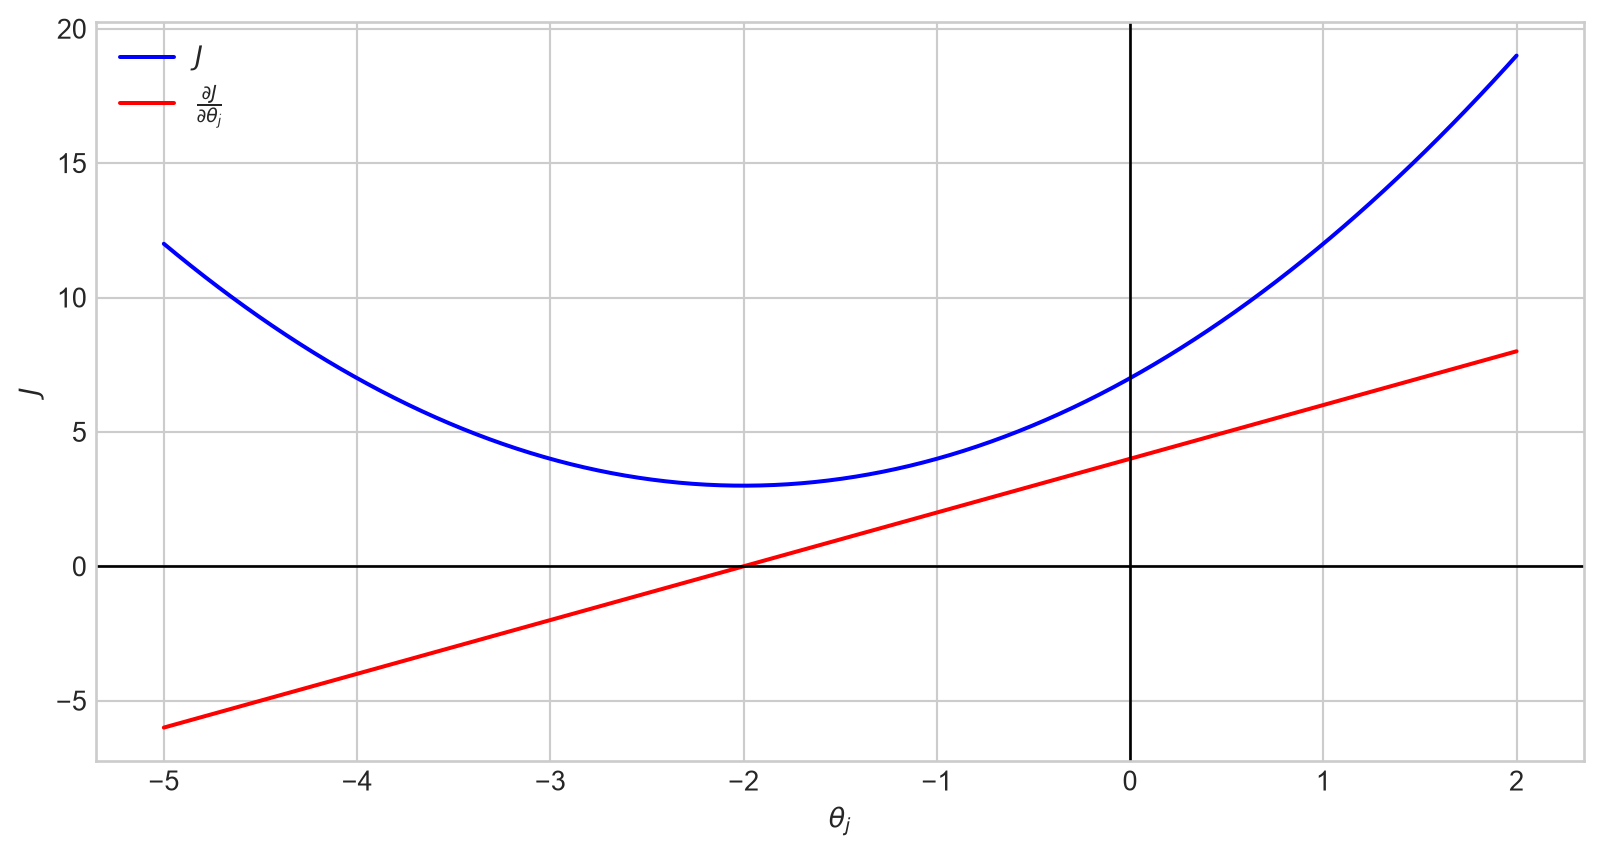
- répéter jusqu’à convergence : \theta_j := \theta_j - \alpha \frac {\partial}{\partial \theta_j}J(\theta_0, \theta_1) , \text{pour } j=0 \text{ et } j=1
- \alpha est appelé le taux d’apprentissage - c’est la taille de chaque pas.
- \frac {\partial}{\partial \theta_j}J(\theta_0, \theta_1) est la dérivée partielle par rapport à \theta_j.
Mise à jour unidimensionnelle
Mise à jour unidimensionnelle
Dérivées partielles
Étant donnée
J(\theta_0, \theta_1) = \frac{1}{N}\sum_{i=1}^N [h_\theta(x_i) - y_i]^2 = \frac{1}{N}\sum_{i=1}^N [\theta_0 + \theta_1 x_i - y_i]^2
Nous avons
\frac {\partial}{\partial \theta_0}J(\theta_0, \theta_1) = \frac{2}{N} \sum\limits_{i=1}^{N} [\theta_0 + \theta_1 x_i - y_i]
et
\frac {\partial}{\partial \theta_1}J(\theta_0, \theta_1) = \frac{2}{N} \sum\limits_{i=1}^{N} x_i [\theta_0 + \theta_1 x_i - y_i]
Dérivée partielle (SymPy)
from IPython.display import Math, display
import sympy as sp

# Définir l'indice, les paramètres et les données indexées.
i, N = sp.symbols("i N", integer=True, positive=True)
theta_0, theta_1 = sp.symbols("theta_0 theta_1")
x_data = sp.IndexedBase("x")
y_data = sp.IndexedBase("y")
h_i = theta_0 + theta_1 * x_data[i]

print("Fonction d'hypothèse :")
display(Math(r"h_\theta(x_i) = " + sp.latex(h_i)))
Fonction d'hypothèse :\displaystyle h_\theta(x_i) = \theta_{0} + \theta_{1} {x}_{i}
Dérivée partielle (SymPy)
Fonction de perte :\displaystyle J = \frac{\sum_{i=1}^{N} \left(\theta_{0} + \theta_{1} {x}_{i} - {y}_{i}\right)^{2}}{N}
Dérivée partielle (SymPy)
Dérivée partielle par rapport à theta_0 :\displaystyle \frac{\sum_{i=1}^{N} \left(2 \theta_{0} + 2 \theta_{1} {x}_{i} - 2 {y}_{i}\right)}{N}
Dérivée partielle (SymPy)
Dérivée partielle par rapport à theta_1 :\displaystyle \frac{\sum_{i=1}^{N} 2 \left(\theta_{0} + \theta_{1} {x}_{i} - {y}_{i}\right) {x}_{i}}{N}
Régression linéaire multivariée
h_\theta(x_i) = \sum_{j=0}^{D}\theta_j x_i^{(j)} = \theta^\top x_i, \qquad x_i^{(0)}=1
\begin{align*} x_i^{(j)} &= \text{valeur de l'attribut } j \text{ dans le } i \text{ème exemple} \\ D &= \text{le nombre d'attributs} \end{align*}
Descente de gradient — cas multivarié
La nouvelle fonction de perte est
J(\theta) = \dfrac {1}{N} \displaystyle \sum _{i=1}^N [h_\theta(x_i) - y_i]^2
Sa dérivée partielle :
\frac {\partial}{\partial \theta_j}J(\theta) = \frac{2}{N} \sum\limits_{i=1}^N x_i^{(j)} [\theta^\top x_i - y_i]
Ici, \theta et x_i sont des vecteurs. Leur produit scalaire, \theta^\top x_i, et l’étiquette y_i sont des scalaires.
Vecteur gradient
Le vecteur contenant la dérivée partielle de J (par rapport à \theta_j, pour j \in \{0, 1 \ldots D\}) est appelé le vecteur gradient.
\nabla_\theta J(\theta) = \begin{pmatrix} \frac {\partial}{\partial \theta_0}J(\theta) \\ \frac {\partial}{\partial \theta_1}J(\theta) \\ \vdots \\ \frac {\partial}{\partial \theta_D}J(\theta)\\ \end{pmatrix}
- Ce vecteur donne la direction de la plus forte pente ascendante.
- Il donne son nom à l’algorithme de descente de gradient :
\theta^{(t+1)} = \theta^{(t)} - \alpha \nabla_\theta J(\theta^{(t)})
Descente de gradient - multivariée
L’algorithme de descente de gradient devient :
Répétez jusqu’à convergence :
\begin{aligned} \{ & \\ \theta_j := & \theta_j - \alpha \frac {\partial}{\partial \theta_j}J(\theta_0, \theta_1, \ldots, \theta_D) \\ & \text{pour } j \in \{0, \ldots, D\} \textbf{ (mettre à jour simultanément)} \\ \} & \end{aligned}
Descente de gradient - multivariée
Répétez jusqu’à convergence :
\begin{aligned} \; \{ & \\ \; & \theta_0 := \theta_0 - \alpha \frac{2}{N} \sum\limits_{i=1}^{N} x_i^{(0)}[h_\theta(x_i) - y_i] \\ \; & \theta_1 := \theta_1 - \alpha \frac{2}{N} \sum\limits_{i=1}^{N} x_i^{(1)}[h_\theta(x_i) - y_i] \\ \; & \theta_2 := \theta_2 - \alpha \frac{2}{N} \sum\limits_{i=1}^{N} x_i^{(2)}[h_\theta(x_i) - y_i] \\ & \cdots \\ \} & \end{aligned}
Hypothèses
Quelles étaient nos hypothèses ?
- La fonction (objectif/de perte) est différentiable.
Minimum local ou global
Une fonction est convexe si, pour toute paire de points sur son graphe, le segment qui les relie se trouve au-dessus du graphe ou sur celui-ci.
- Tout minimum local d’une fonction convexe est un minimum global.
- Une fonction convexe peut avoir plus d’un minimum global.
- L’objectif EQM de la régression linéaire est convexe.
Pour une fonction non convexe, la descente de gradient peut s’approcher d’un minimum local ou d’un autre point stationnaire, ou encore ne pas converger.
Les objectifs standards de la régression linéaire, de la régression logistique et des machines à vecteurs de support linéaires sont convexes par rapport à leurs paramètres. Les objectifs d’entraînement des réseaux de neurones ne le sont généralement pas.
Minimum local ou global

Objectif non borné
Code
# 1. Définir la variable symbolique et la fonction
x = sp.Symbol('x', real=True)
f_expr = 2*x**3 + 4*x**2 - 5*x + 1

# 2. Calculer la dérivée de f
f_prime_expr = sp.diff(f_expr, x)

# 3. Convertir les expressions symboliques en fonctions Python
f = sp.lambdify(x, f_expr, 'numpy')
f_prime = sp.lambdify(x, f_prime_expr, 'numpy')

# 4. Générer une plage de valeurs x
x_vals = np.linspace(-4, 2, 1000)

# 5. Calculer f et f' sur cette plage
y_vals = f(x_vals)
y_prime_vals = f_prime(x_vals)

# 6. Préparer les chaînes LaTeX pour la légende
f_label = rf'$f(x) = {sp.latex(f_expr)}$'
f_prime_label = rf'$f^\prime(x) = {sp.latex(f_prime_expr)}$'

# 7. Tracer f et f', avec les équations dans la légende
plt.figure(figsize=(8, 4))
plt.plot(x_vals, y_vals, label=f_label)
plt.plot(x_vals, y_prime_vals, label=f_prime_label)

# 8. Colorier la région entre l'axe x et f'(x) pour tout le domaine
plt.fill_between(x_vals, y_prime_vals, 0, color='gray', alpha=0.2, interpolate=True,
                 label='Région entre 0 et f\'(x)')

# 9. Ajouter une ligne de référence, des étiquettes, une légende, etc.
plt.axhline(0, color='black', linewidth=0.5)
plt.title(rf'Fonction et sa dérivée avec ombrage pour $f^\prime(x)$')
plt.xlabel('x')
plt.ylabel('y')
plt.legend()
plt.grid(True)
plt.show()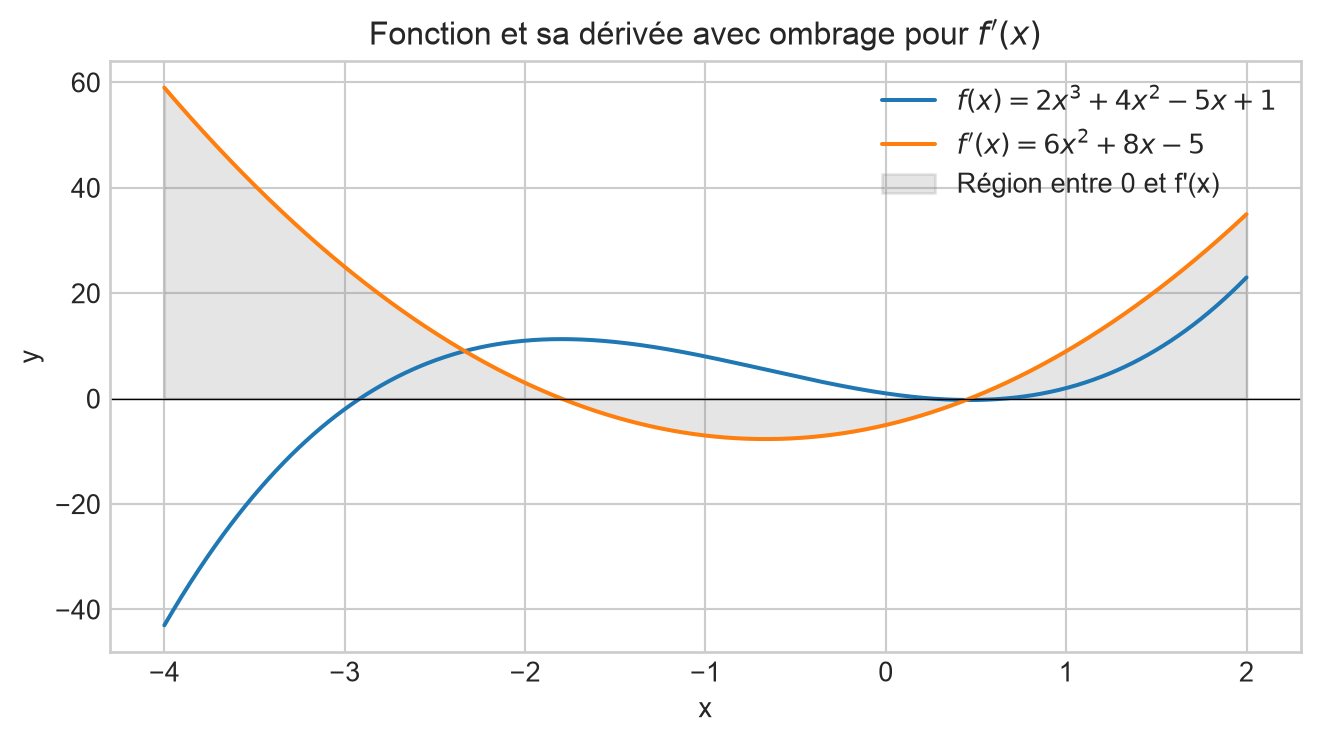
Taux d’apprentissage
Taux d’apprentissage
Code
import numpy as np
import matplotlib.pyplot as plt

def f(x):
    return x**2

def grad_f(x):
    return 2*x

# Estimation initiale, taux d'apprentissage et nombre d'étapes de descente de gradient
x_current = 2.0
learning_rate = 1.1  # Trop grand => divergence
num_iterations = 5   # Nous ferons cinq mises à jour

# Stocker chaque valeur de x dans une liste (trajectoire) pour l'affichage
trajectory = [x_current]

# Effectuer la descente de gradient
for _ in range(num_iterations):
    g = grad_f(x_current)
    x_current = x_current - learning_rate * g
    trajectory.append(x_current)

# Préparer les données pour l'affichage
x_vals = np.linspace(-5, 5, 1000)
y_vals = f(x_vals)

# Tracer la fonction f(x)
plt.figure(figsize=(6, 5))
plt.plot(x_vals, y_vals, label=r"$f(x) = x^2$")
plt.axhline(0, color='black', linewidth=0.5)

# Tracer la trajectoire, en étiquetant chaque itération
for i, x_t in enumerate(trajectory):
    y_t = f(x_t)
    # Tracer le point
    plt.plot(x_t, y_t, 'ro')
    # Étiqueter le numéro d'itération
    plt.text(x_t, y_t, f"  {i}", color='red')
    # Connecter les points consécutifs
    if i > 0:
        x_prev = trajectory[i - 1]
        y_prev = f(x_prev)
        plt.plot([x_prev, x_t], [y_prev, y_t], 'r--')

# Finitions
plt.title("Divergence de la descente de gradient avec un grand taux d'apprentissage")
plt.xlabel("x")
plt.ylabel("f(x)")
plt.legend()
plt.grid(True)
plt.show()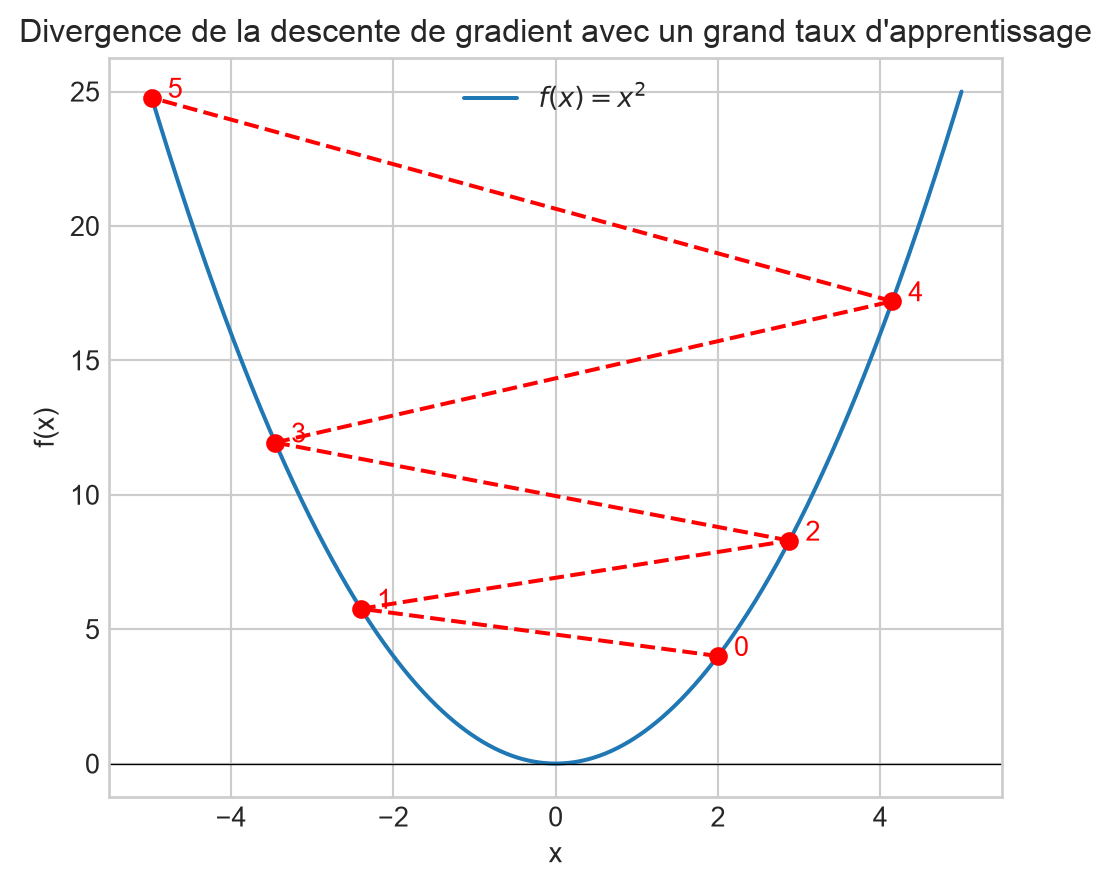
Descente de gradient par lot
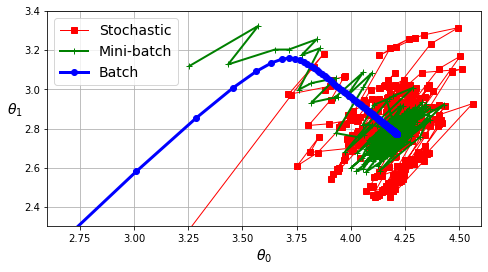
- Cet algorithme est appelé descente de gradient par lot, car chaque mise à jour utilise l’ensemble d’entraînement complet.
- Des attributs sur des échelles très différentes peuvent rendre l’objectif mal conditionné et ralentir la convergence.
Descente de gradient par lot - inconvénient
- Chaque mise à jour par lot devient plus coûteuse lorsque le nombre d’exemples d’entraînement augmente.
- Chaque mise à jour traite tous les exemples d’entraînement; la méthode peut donc devenir impraticable lorsque les données ne tiennent pas en mémoire.
Descente de gradient stochastique
La descente de gradient stochastique utilise un exemple d’entraînement pour chaque mise à jour des paramètres. Les exemples sont normalement mélangés avant chaque époque.
- Chaque mise à jour est peu coûteuse, ce qui convient aux grands jeux de données ou aux flux de données.
- Sa trajectoire est plus bruitée que celle de la descente de gradient par lot.
- Pour un objectif non convexe, ce bruit peut aider à s’éloigner de certains points selles ou minima locaux peu profonds.
- Le bruit ne garantit pas la convergence vers un minimum global.
Taille du mini-lot
Un mini-lot estime le gradient sur un sous-ensemble aléatoire du jeu d’entraînement.
Code
# Utiliser une même séquence mélangée afin que chaque mini-lot plus grand
# contienne les exemples mis en évidence dans le panneau précédent.
rng = np.random.default_rng(42)
shuffled_indices = rng.permutation(len(y_train))

batch_sizes = [1, 4, 16, len(y_train)]
batch_colours = ["#0072B2", "#E69F00", "#009E73", "#CC79A7"]
batch_titles = [
    r"$B=1$ (stochastique)",
    r"$B=4$",
    r"$B=16$",
    rf"$B=N={len(y_train)}$ (lot complet)",
]

fig, axes = plt.subplots(2, 2, figsize=(10, 5), sharex=True, sharey=True)
x_train = X_train[:, 0]

for ax, batch_size, colour, title in zip(
    axes.flat, batch_sizes, batch_colours, batch_titles
):
    selected = shuffled_indices[:batch_size]
    ax.scatter(x_train, y_train, color="lightgray", s=18, alpha=0.65)
    ax.scatter(
        x_train[selected],
        y_train[selected],
        color=colour,
        edgecolor="white",
        linewidth=0.4,
        s=42,
    )
    ax.set_title(title)
    ax.grid(alpha=0.2)

fig.supxlabel("Durée de l'éruption (min)")
fig.supylabel("Attente avant la prochaine éruption (min)")
plt.tight_layout()
plt.show()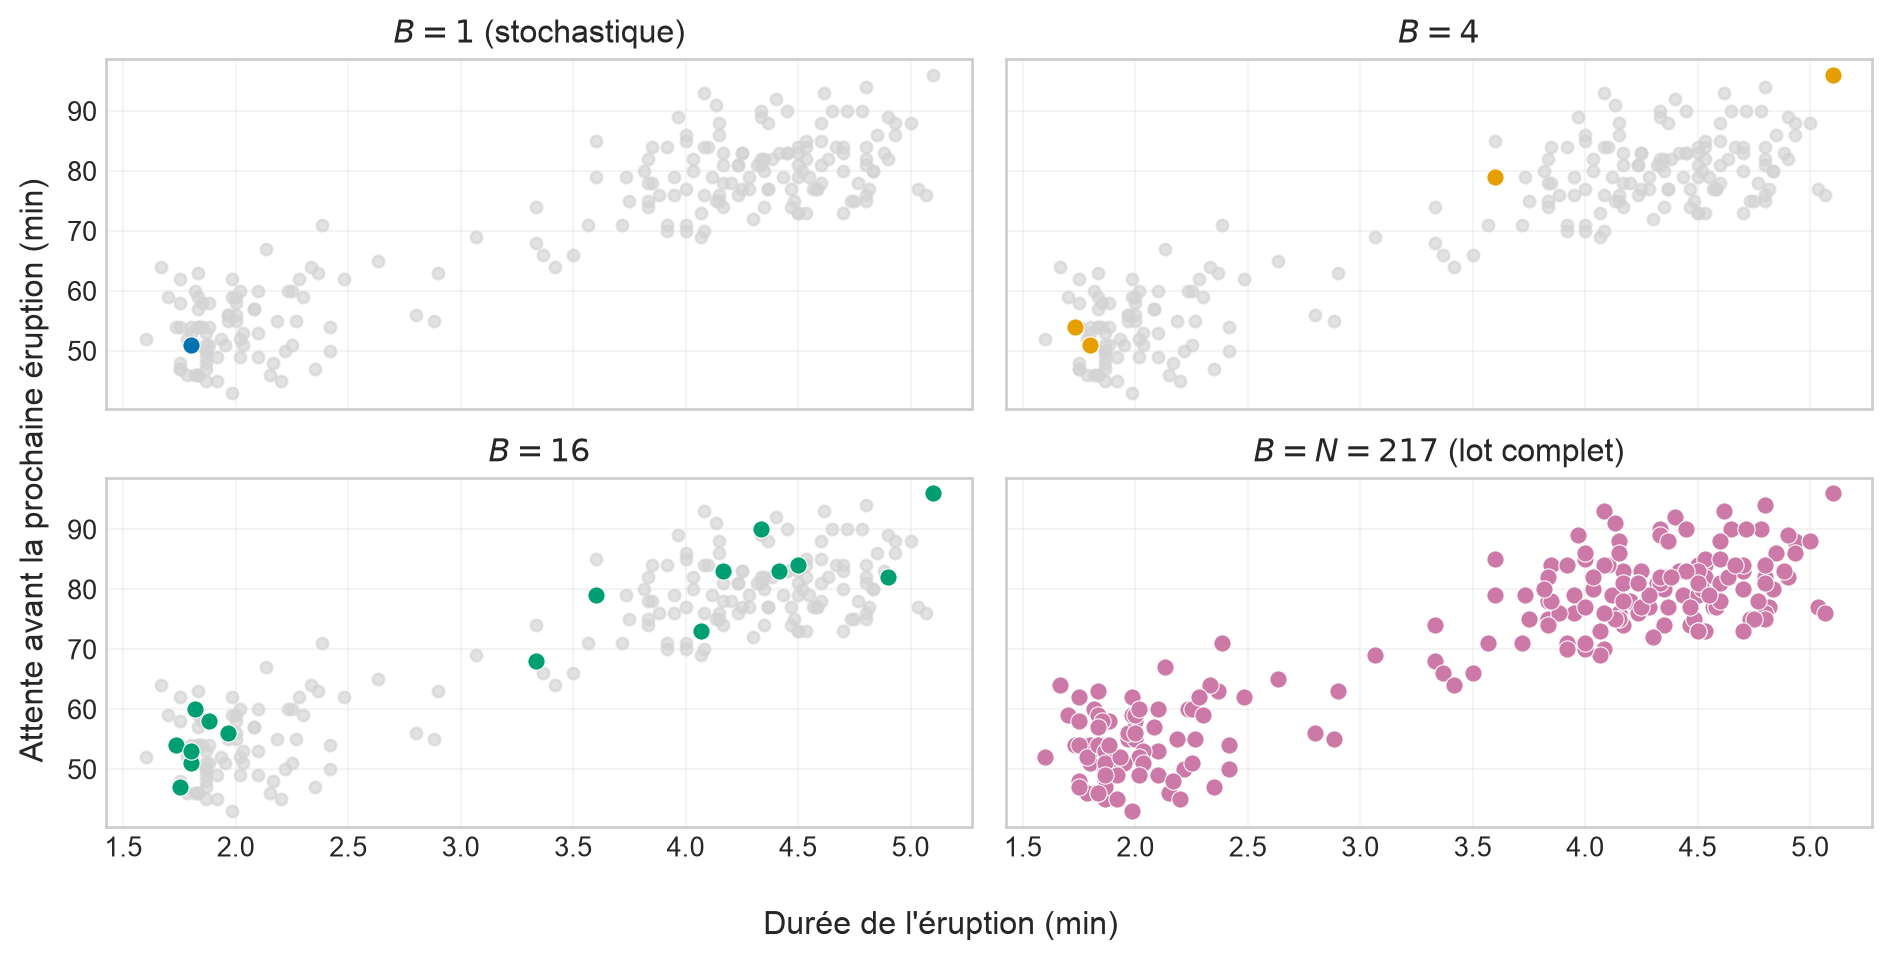
Stochastique, mini-lots, lot
Sommaire
La descente de gradient par lot calcule un gradient exact sur toutes les données, mais chaque mise à jour peut être coûteuse pour un grand jeu de données.
La descente de gradient stochastique effectue des mises à jour peu coûteuses mais bruitées, et peut traiter les exemples de façon incrémentale.
La descente de gradient par mini-lots équilibre le bruit du gradient, l’efficacité des opérations matricielles et l’accélération matérielle.
Optimisation et réseaux profonds
Nous allons brièvement revisiter le sujet en discutant des réseaux de neurones artificiels profonds, pour lesquels il existe des algorithmes d’optimisation spécialisés.
- Optimisation par Momentum
- Gradient Acceleré de Nesterov
- AdaGrad
- RMSProp
- Adam et Nadam
Dernier mot
- L’optimisation est un sujet vaste. D’autres algorithmes existent et sont utilisés dans d’autres contextes.
- Parmi eux :
- L’optimisation par essaims particulaires (PSO), les algorithmes génétiques (GA), et les algorithmes de colonie d’abeilles artificielles (ABC).
Prologue
Régression linéaire — sommaire (1/2)
- Dans une tâche de régression, le modèle prédit une étiquette à valeur réelle.
- Un vecteur de paramètres \theta est un point de l’espace des paramètres. Chaque valeur de \theta détermine une fonction h_\theta dans l’espace des hypothèses.
- L’erreur quadratique moyenne J(\theta) évalue un choix de paramètres sur un jeu de données fixe. L’entraînement cherche des paramètres dont la valeur de l’objectif est plus faible.
Régression linéaire — sommaire (2/2)
- La descente de gradient met à jour tous les paramètres selon \theta \leftarrow \theta - \alpha \nabla J(\theta), où le taux d’apprentissage \alpha contrôle la taille du pas.
- Pour la régression linéaire, l’objectif EQM est convexe; tout minimum local est donc aussi un minimum global.
- Les descentes de gradient par lot, stochastique et par mini-lots diffèrent par le nombre d’exemples d’entraînement qui contribuent à chaque mise à jour.
Andrew Ng
- Gradient Descent (Math)
(11:30 m) - Intuition
(11:51 m) - Linear Regression
(10:20 m) - ML-005 | Stanford | Andrew Ng
(19 videos)
Herman Kamper
Mathématiques
3Blue1Brown
- Essence de l’algèbre linéaire
- Une série de 16 vidéos (10 à 15 minutes par vidéo) offrant “une compréhension géométrique des matrices, déterminants, valeurs propres et plus encore.”
- 6 662 732 vues au 30 septembre 2019.
- Une série de 16 vidéos (10 à 15 minutes par vidéo) offrant “une compréhension géométrique des matrices, déterminants, valeurs propres et plus encore.”
- Essence du calcul
- Une série de 12 vidéos (15 à 20 minutes par vidéo) : “L’objectif ici est de faire en sorte que le calcul apparaisse comme quelque chose que vous auriez pu découvrir vous-même.”
- 2 309 726 vues au 30 septembre 2019.
- Une série de 12 vidéos (15 à 20 minutes par vidéo) : “L’objectif ici est de faire en sorte que le calcul apparaisse comme quelque chose que vous auriez pu découvrir vous-même.”
Prochain cours
- Régression logistique
Annexe
Régression linéaire
Code
import numpy as np

X = 6 * np.random.rand(100, 1) - 4
y = X ** 2 - 4 * X + 5 + np.random.randn(100, 1)

from sklearn.linear_model import LinearRegression

lin_reg = LinearRegression()
lin_reg.fit(X, y)

X_new = np.array([[-4], [2]])
y_pred = lin_reg.predict(X_new)

import matplotlib as mpl
import matplotlib.pyplot as plt

plt.plot(X, y, "b.")
plt.plot(X_new, y_pred, "r-")
plt.xlabel("$x$", fontsize=18)
plt.ylabel("$y$", rotation=0, fontsize=18)
plt.axis([-4, 2, -1, 35])
# save_fig("regression_linear-01")
plt.show()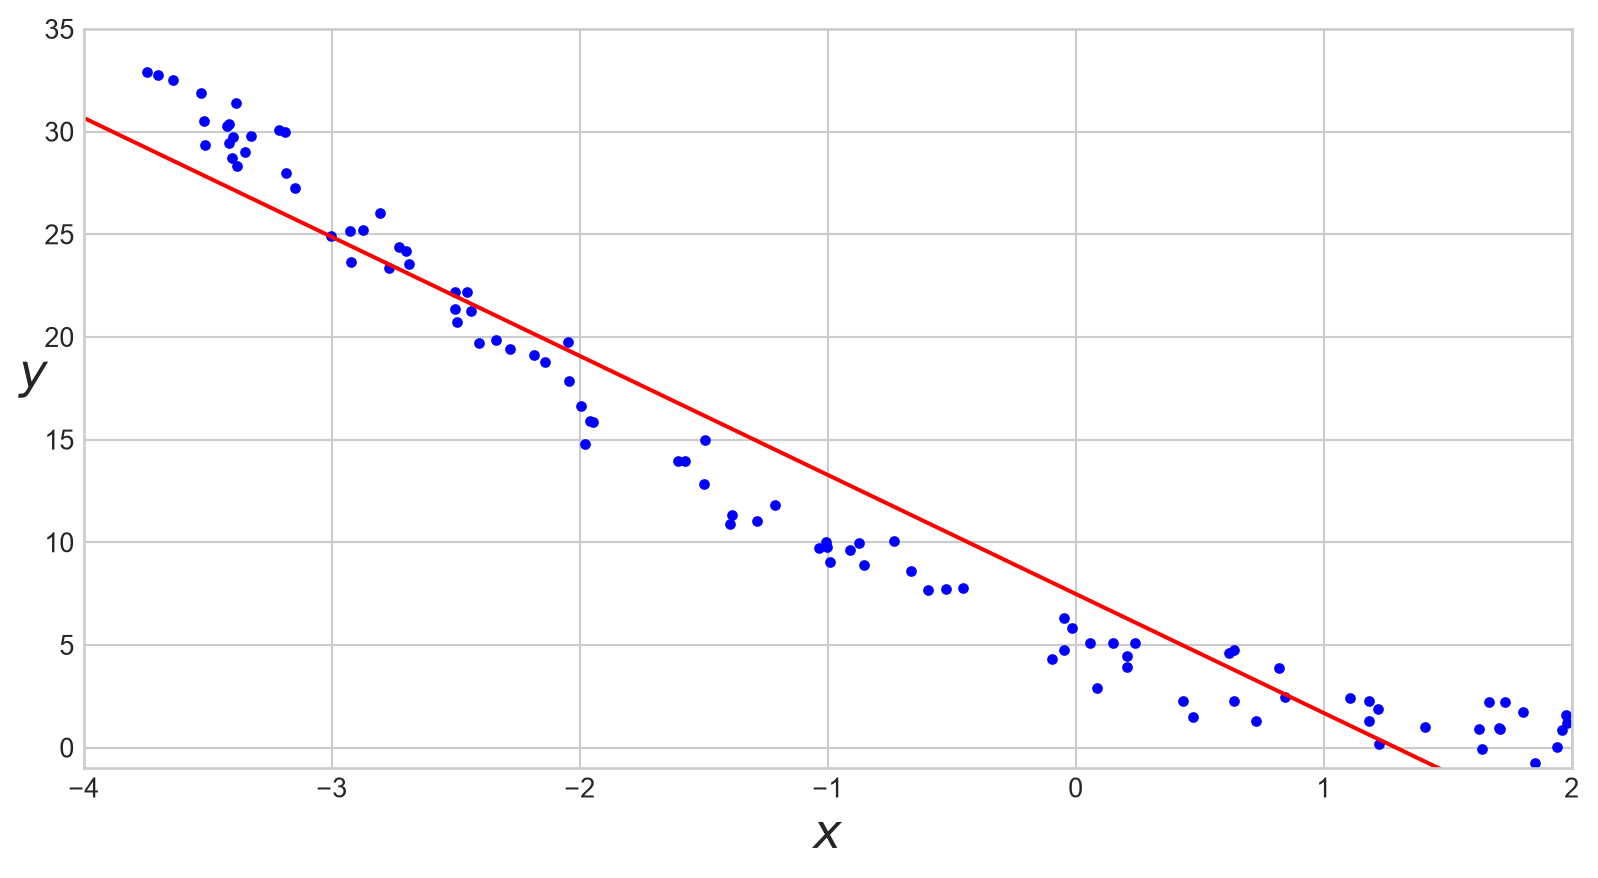
Code source
Interactions GPT 4o (2024-09-14)
Utilisateur : Expliquez le code sur l’écran précédent ligne par ligne.
IA : Certainement ! Voici une explication ligne par ligne du code fourni :
- Explication : Cette ligne importe la bibliothèque NumPy, qui est un paquet fondamental pour les calculs numériques en Python. Elle est couramment utilisée pour travailler avec des tableaux et des matrices, ainsi que pour effectuer diverses opérations mathématiques.
- Explication : Cette ligne génère un tableau NumPy
Xcontenant 100 lignes et 1 colonne de nombres aléatoires. La fonctionnp.random.rand(100, 1)génère des nombres aléatoires uniformément distribués entre 0 et 1. La multiplication par 6 ajuste ces nombres à la plage [0, 6), et la soustraction de 4 déplace la plage à [-4, 2).
Explication : Cette ligne génère la variable cible
ybasée sur une équation quadratique avec du bruit ajouté. Plus précisément :X ** 2calcule le carré de chaque élément deX.- 4 * Xsoustrait quatre fois chaque élément deX.+ 5ajoute une constante de 5.+ np.random.randn(100, 1)ajoute du bruit gaussien avec une moyenne de 0 et un écart-type de 1 à chaque élément, rendant les données plus réalistes en introduisant une certaine variabilité.
- Explication : Cette ligne importe la classe
LinearRegressiondu modulesklearn.linear_model, qui fait partie de la bibliothèque Scikit-Learn. Scikit-Learn est largement utilisée pour l’apprentissage automatique en Python.
- Explication : Cette ligne crée une instance de la classe
LinearRegressionet l’assigne à la variablelin_reg. Cet objet sera utilisé pour ajuster le modèle de régression linéaire aux données.
- Explication : Cette ligne ajuste le modèle de régression linéaire aux données en trouvant la meilleure ligne passant par les points
(X, y). La méthodefitentraîne le modèle en utilisant les attributs fournisXet la variable cibley.
- Explication : Cette ligne crée un nouveau tableau NumPy
X_newavec deux valeurs : -4 et 2. Ces valeurs représentent de nouveaux points de données pour lesquels nous voulons prédire la variable cible en utilisant le modèle entraîné.
- Explication : Cette ligne utilise le modèle de régression linéaire entraîné pour prédire la variable cible
y_predpour les nouveaux points de données dansX_new. La méthodepredictrenvoie les valeurs prédites basées sur le modèle ajusté.
En résumé, ce script génère des données synthétiques, ajuste un modèle de régression linéaire à ces données, puis utilise le modèle pour faire des prédictions sur de nouveaux points de données.
Code source (suite)
import os
import matplotlib as mpl
import matplotlib.pyplot as plt

def save_fig(fig_id, tight_layout=True, fig_extension="pdf", resolution=300):
    path = os.path.join(fig_id + "." + fig_extension)
    print("Saving figure", fig_id)
    if tight_layout:
        plt.tight_layout()
    plt.savefig(path, format=fig_extension, dpi=resolution)
Code source (suite)
Références
Azzalini, A., et A. W. Bowman. 1990. « A Look at Some Data on the Old Faithful Geyser ». Journal of the Royal Statistical Society Series C: Applied Statistics 39 (3): 357‑65. https://doi.org/10.2307/2347385.
Géron, Aurélien. 2022. Hands-on Machine Learning with Scikit-Learn, Keras, and TensorFlow. 3ᵉ éd. O’Reilly Media, Inc.
Russell, Stuart, et Peter Norvig. 2020. Artificial Intelligence: A Modern Approach. 4ᵉ éd. Pearson. http://aima.cs.berkeley.edu/.
Stanton, Jeffrey M. 2001. « Galton, Pearson, and the Peas: A Brief History of Linear Regression for Statistics Instructors ». Journal of Statistics Education 9 (3). https://doi.org/10.1080/10691898.2001.11910537.
Marcel Turcotte
École de science informatique et de génie électrique (SIGE)
Université d’Ottawa