Introduction à l’apprentissage automatique

CSI 4506 - Automne 2026

Marcel Turcotte

Version: sept. 13, 2026 17h01

Préambule

Message du jour (1/2)

Message du jour (2/2)

Rappel du cours précédent

  • Les méthodes symboliques et connexionnistes constituent deux grandes traditions de l’IA.
  • Définir l’intelligence demeure difficile.
  • Russell et Norvig décrivent quatre perspectives sur l’IA : penser comme un humain, agir comme un humain, penser rationnellement et agir rationnellement.
  • L’IA étroite vise des tâches particulières; l’intelligence artificielle générale constitue un objectif plus vaste et controversé.
  • Des questions difficiles et non résolues concernent notamment l’incarnation, l’agentivité, la sensibilité, la conscience, les émotions et la cognition.

Objectifs d’apprentissage

  • Distinguer l’apprentissage supervisé, non supervisé et par renforcement selon la rétroaction disponible
  • Identifier les exemples, les attributs et les cibles dans un jeu de données supervisé
  • Différencier la classification de la régression, ainsi que l’apprentissage de l’inférence
  • Appliquer le flux de travail élémentaire de scikit-learn : charger et explorer des données, ajuster un modèle et effectuer des prédictions
  • Expliquer pourquoi un jeu de test distinct est nécessaire pour estimer la performance sur des données inédites

Introduction

Justification

Pourquoi un programme informatique devrait-il apprendre ?

Définition

Mitchell (1997), page 2

Un programme informatique apprend à partir de l’expérience \(E\) par rapport à une certaine classe de tâches \(T\) et une mesure de performance \(P\), si sa performance pour les tâches dans \(T\), mesurée par \(P\), s’améliore avec l’expérience \(E\).

Concepts

Voir: images/svg/ml_concepts-00.svg

Types de problèmes

Nous commencerons par trois grands cadres d’apprentissage, distingués selon la rétroaction disponible :

  1. Apprentissage non supervisé : Les exemples n’ont pas d’étiquettes cibles.
  2. Apprentissage supervisé : Chaque exemple d’entraînement est accompagné d’une cible.
  3. Apprentissage par renforcement : Un agent reçoit des récompenses numériques en interagissant avec un environnement.

L’apprentissage supervisé est le cadre le plus étudié dans ce cours et sans doute le plus intuitif pour commencer.

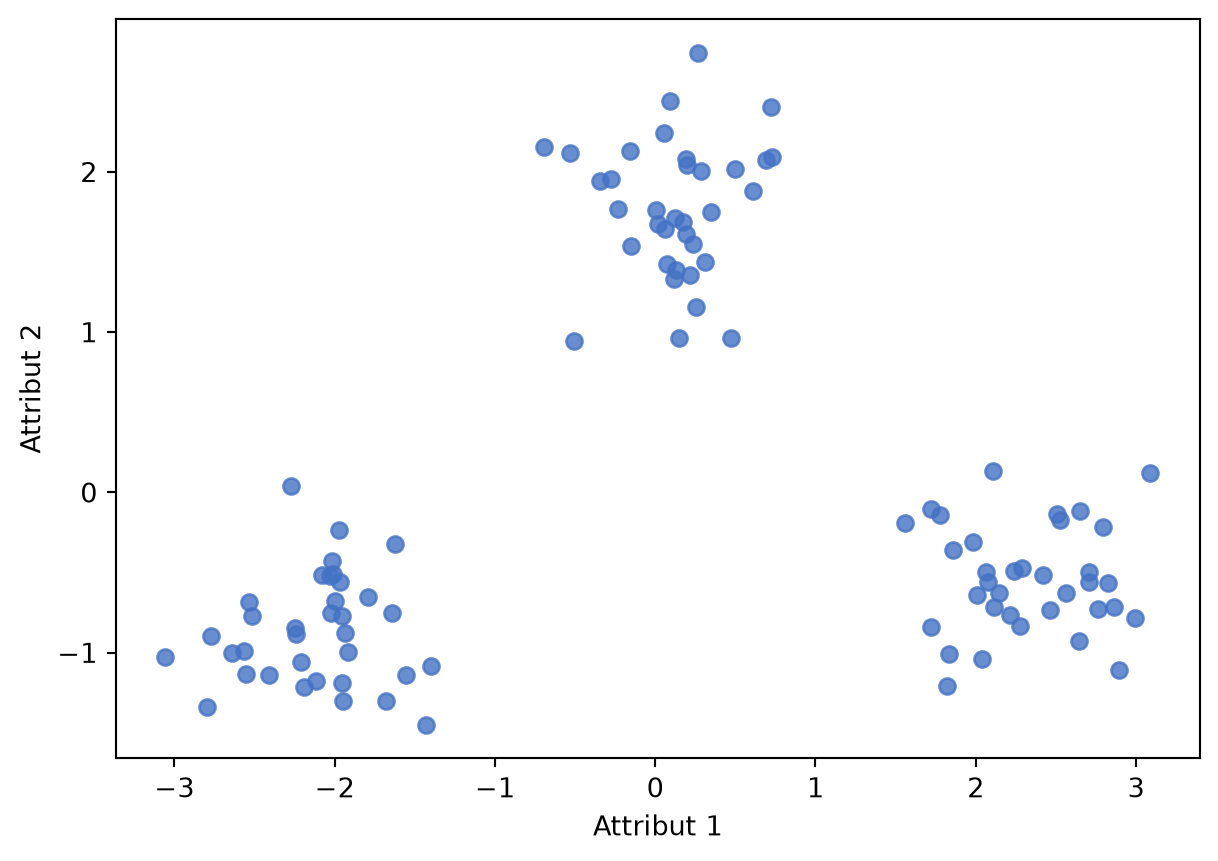
Apprentissage non supervisé

Données : des vecteurs d’attributs \(x_1, x_2, \ldots, x_N\), mais aucune étiquette cible \(y_i\).

Code
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(7)
centres = [(-2.0, -0.8), (0.2, 1.8), (2.3, -0.5)]
points = np.vstack([
    rng.normal(loc=centre, scale=0.42, size=(35, 2))
    for centre in centres
])

plt.scatter(points[:, 0], points[:, 1], color="#4472C4", alpha=0.8)
plt.xlabel("Attribut 1")
plt.ylabel("Attribut 2")
plt.gca().set_aspect("equal", adjustable="box")
plt.show()

Apprentissage par renforcement

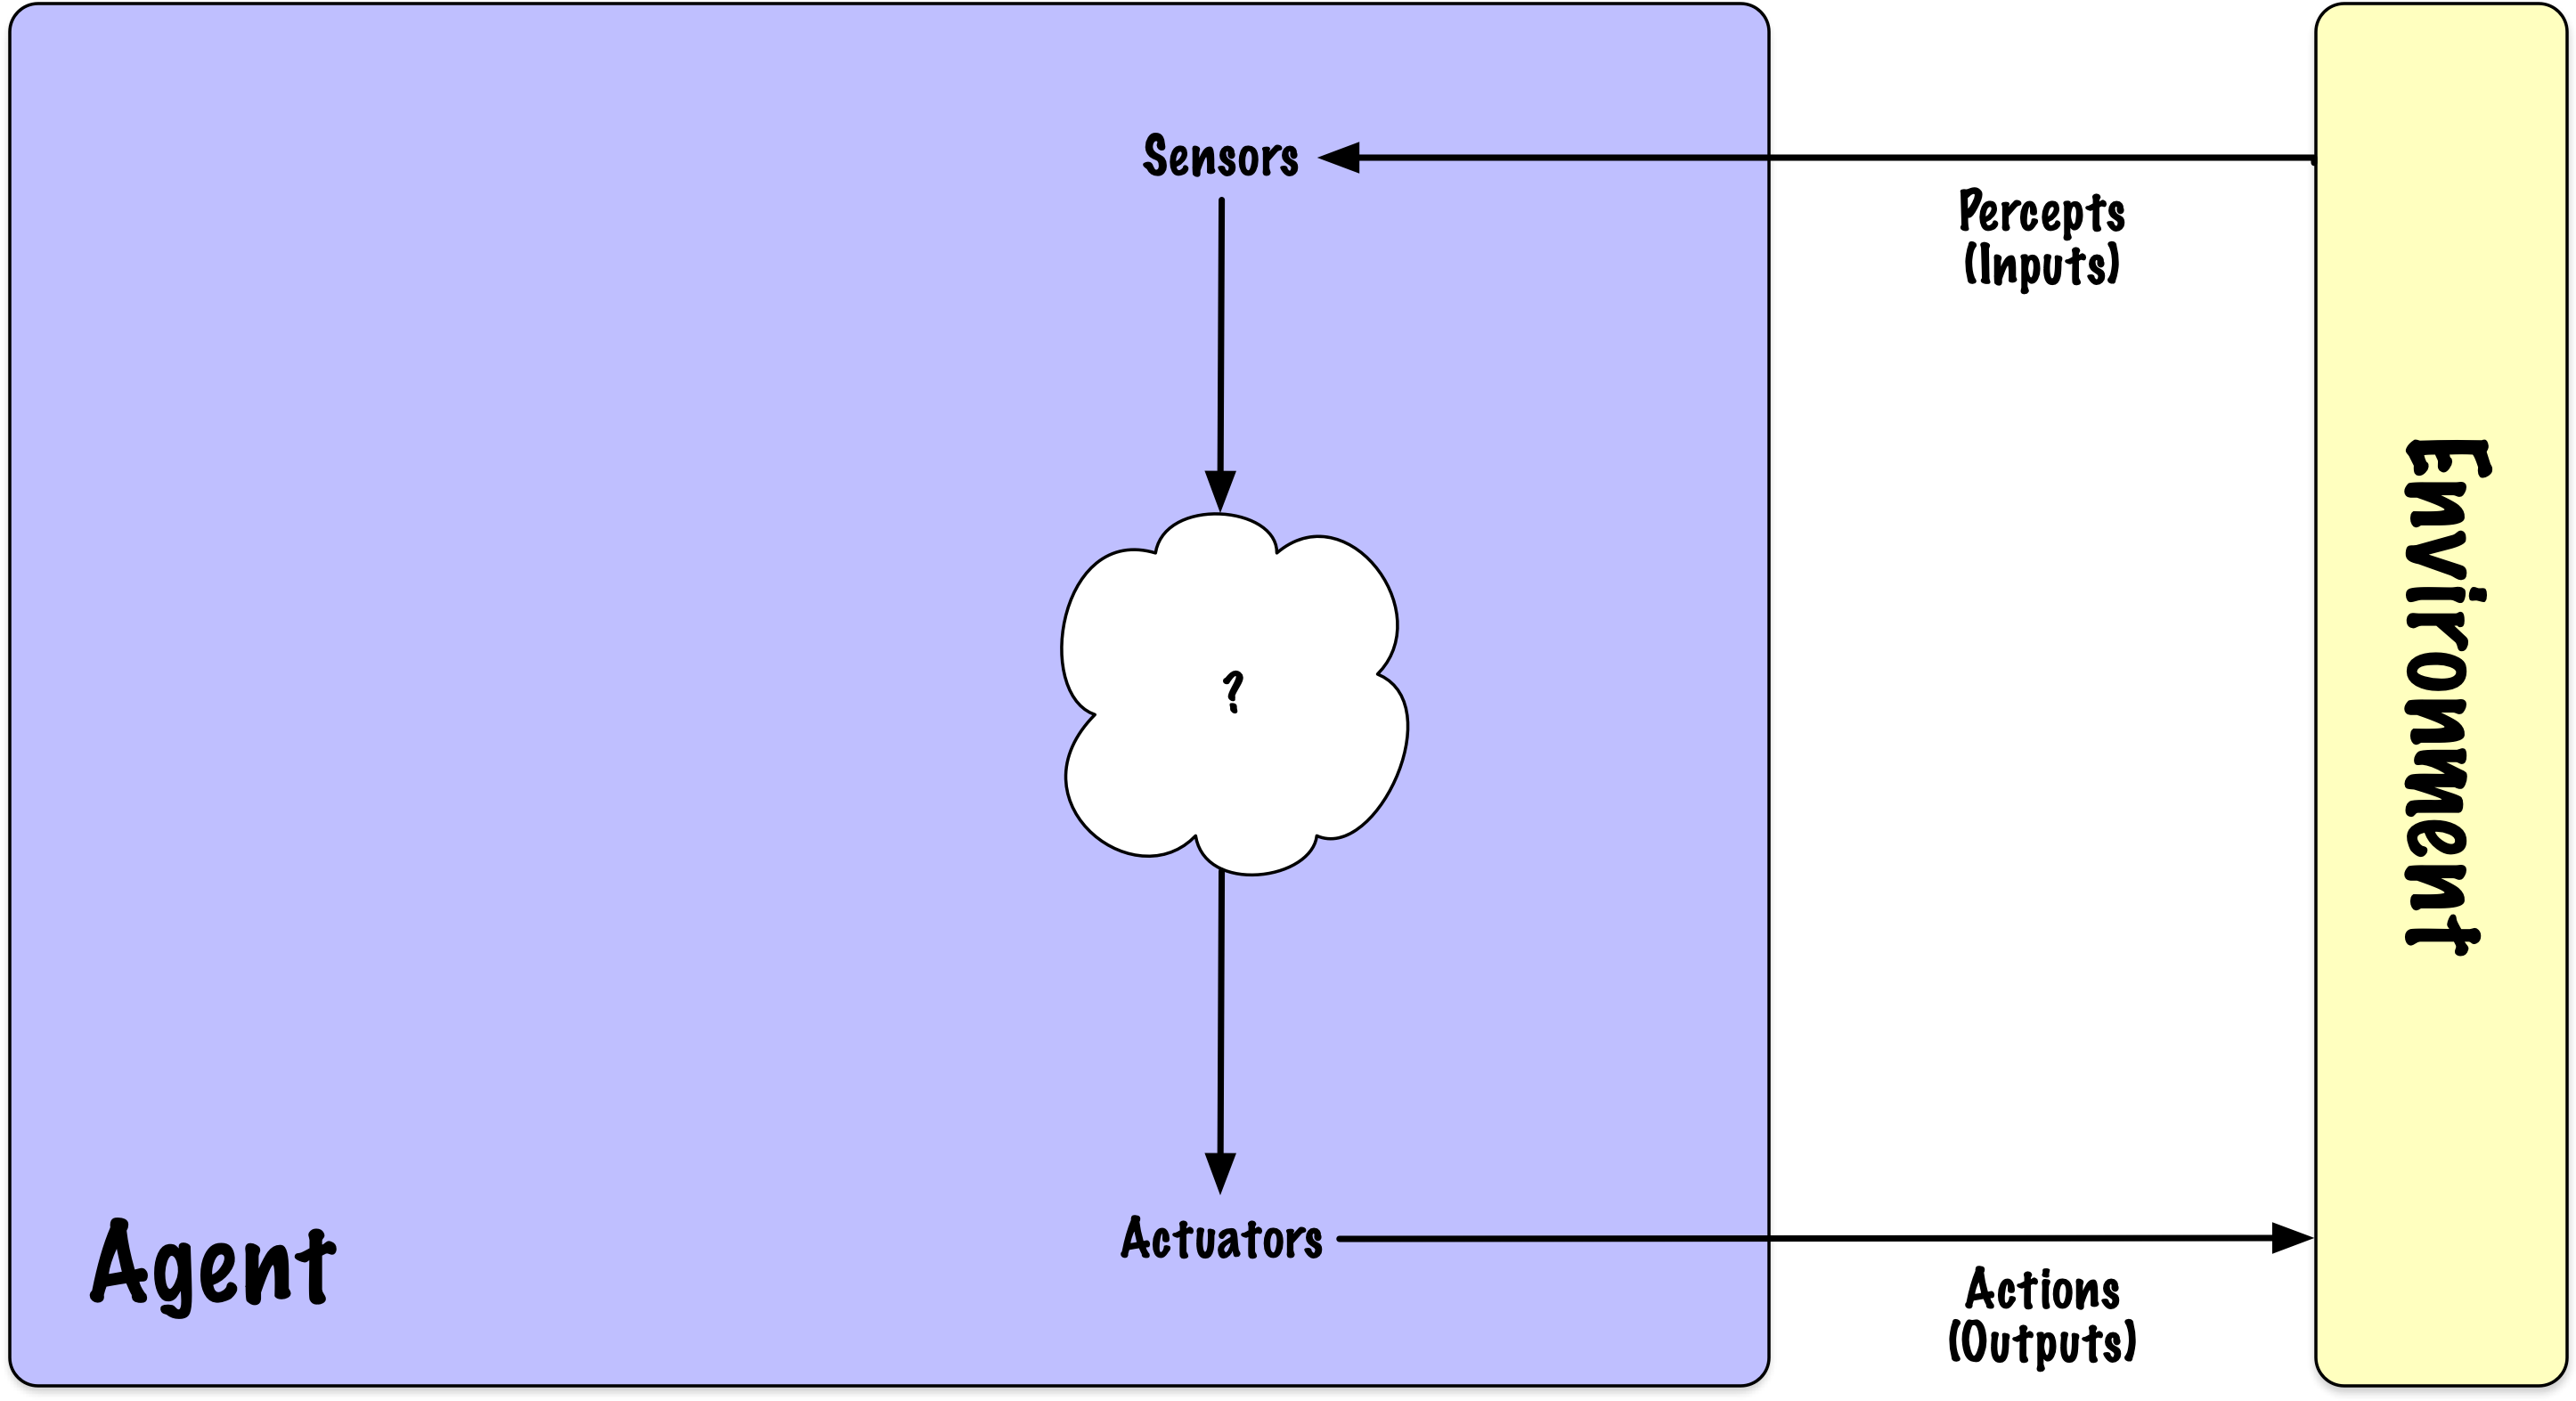
Un agent agit dans un environnement, observe les conséquences de ses actions et reçoit des récompenses numériques.

Objectif : Apprendre une politique qui choisit les actions afin de maximiser la récompense cumulative.

Deux phases

Pour le flux de travail supervisé étudié dans ce cours :

  1. Apprentissage (construction d’un modèle)
  2. Inférence (utilisation du modèle)

Apprentissage : construir un modèle

Inférence : utilisation d’un modèle

Carp-e Diem! (exemple)

1. Problème : Vont-ils mordre aujourd’hui ?

Objectif : Développer un modèle prédictif qui classe une journée de pêche comme médiocre, moyenne ou excellente.

2. Attributs (caractéristiques)

Les traditions et certains guides de pêche, dont The Old Farmer’s Almanac, utilisent souvent la phase de la lune pour recommander des journées de pêche. Nous la traiterons comme un attribut candidat; son utilité prédictive demeure une question empirique.

  • Phase de la lune (catégorielle) : ‘Nouvelle lune’, ‘Premier quartier’, ‘Pleine lune’ et ‘Dernier quartier’.
  • Prévisions météorologiques (catégorielles) : ‘Pluvieux’, ‘Nuageux’ et ‘Ensoleillé’.
  • Température extérieure (numérique) : La température en Celsius.
  • Température de l’eau (numérique) : La température de l’eau du lac ou de la rivière.

3. Données d’entraînement

Exemple Phase de la lune Prévisions météorologiques Température extérieure (°C) Température de l’eau (°C) Résultat de la pêche
1 Pleine lune Ensoleillé 25 22 Excellente
2 Nouvelle lune Nuageux 18 19 Moyenne
3 Premier quartier Pluvieux 15 17 Médiocre
4 Dernier quartier Ensoleillé 30 24 Excellente
5 Pleine lune Nuageux 20 20 Moyenne
6 Nouvelle lune Pluvieux 22 21 Médiocre

3. Données

Phase de la lune Prévisions météorologiques Température extérieure (°C) Température de l’eau (°C)
Pleine lune Ensoleillé 25 22
Nouvelle lune Nuageux 18 19
Premier quartier Pluvieux 15 17
Dernier quartier Ensoleillé 30 24
Pleine lune Nuageux 20 20
Nouvelle lune Pluvieux 22 21

Les données sont souvent présentées sous forme tabulaire (matrice), où chaque ligne représente un vecteur d’attributs (feature vector), généralement noté \(x_i\), correspondant au \(i\)-ème exemple dans l’ensemble d’entraînement.

3. Étiquettes

Résultat de la pêche
Excellente
Moyenne
Médiocre
Excellente
Moyenne
Médiocre

Les étiquettes sont généralement représentées comme un vecteur colonne, avec \(y_i\) désignant l’étiquette pour le \(i\)-ème exemple.

4. Entraînement du modèle

L’entraînement du modèle utilise des exemples étiquetés pour construire un modèle capable d’effectuer des prédictions. Selon l’algorithme, l’entraînement peut estimer des paramètres, construire une structure ou simplement mémoriser les exemples.

4. Entraînement du modèle (suite)

Un modèle simple qui s’ajuste aux six exemples d’entraînement est le suivant :

  • Si les prévisions sont ensoleillées, prédire excellente.
  • Si les prévisions sont nuageuses, prédire moyenne.
  • Si les prévisions sont pluvieuses, prédire médiocre.

5. Prédiction

À partir de nouvelles données inédites, prédisez la catégorie de la journée de pêche.

  • Phase de la lune : Nouvelle lune
  • Prévisions météorologiques : Ensoleillé
  • Température extérieure : 24°C
  • Température de l’eau : 21°C

Prédiction : Excellente

Cycle de vie

  1. Collecte et préparation des données
  2. Ingénierie des attributs
  3. Entraînement
  4. Évaluation du modèle
  5. Déploiement du modèle
  6. Surveillance et maintenance

Définitions formelles

Apprentissage supervisé (notation)

Le jeu de données (« expérience ») est une collection d’exemples étiquetés.

  • \(\{(x_i, y_i)\}_{i=1}^N\)
    • Chaque \(x_i\) est un vecteur d’attributs (feature vector) à \(D\) dimensions.
    • \(x_i^{(j)}\) est la valeur de l’attribut \(j\) pour l’exemple \(i\), où \(j \in \{1, \ldots, D\}\) et \(i \in \{1, \ldots, N\}\).
    • La cible \(y_i\) peut être une classe appartenant à un ensemble fini \(\{1, 2, \ldots, C\}\), un nombre réel ou un objet structuré, par exemple une séquence, un arbre ou un graphe.

Problème : À partir du jeu de données, construire un modèle capable de prédire la valeur de \(y\) pour un \(x\) inédit.

Apprentissage supervisé (notation, suite)

  • Lorsque la cible \(y_i\) est une classe appartenant à un ensemble fini \(\{1, 2, \ldots, C\}\), il s’agit d’une tâche de classification.

  • Lorsque la cible \(y_i\) est un nombre réel, il s’agit d’une tâche de régression.

Exemple avec du code

scikit-learn

scikit-learn est une bibliothèque libre d’apprentissage automatique qui prend en charge l’apprentissage supervisé et non supervisé. Elle fournit également des outils pour l’ajustement des modèles, le prétraitement des données, la sélection de modèles, l’évaluation et de nombreuses autres tâches.

scikit-learn fournit des dizaines d’algorithmes et de modèles intégrés, appelés estimateurs.

Construite sur NumPy, SciPy et matplotlib.

scikit-learn

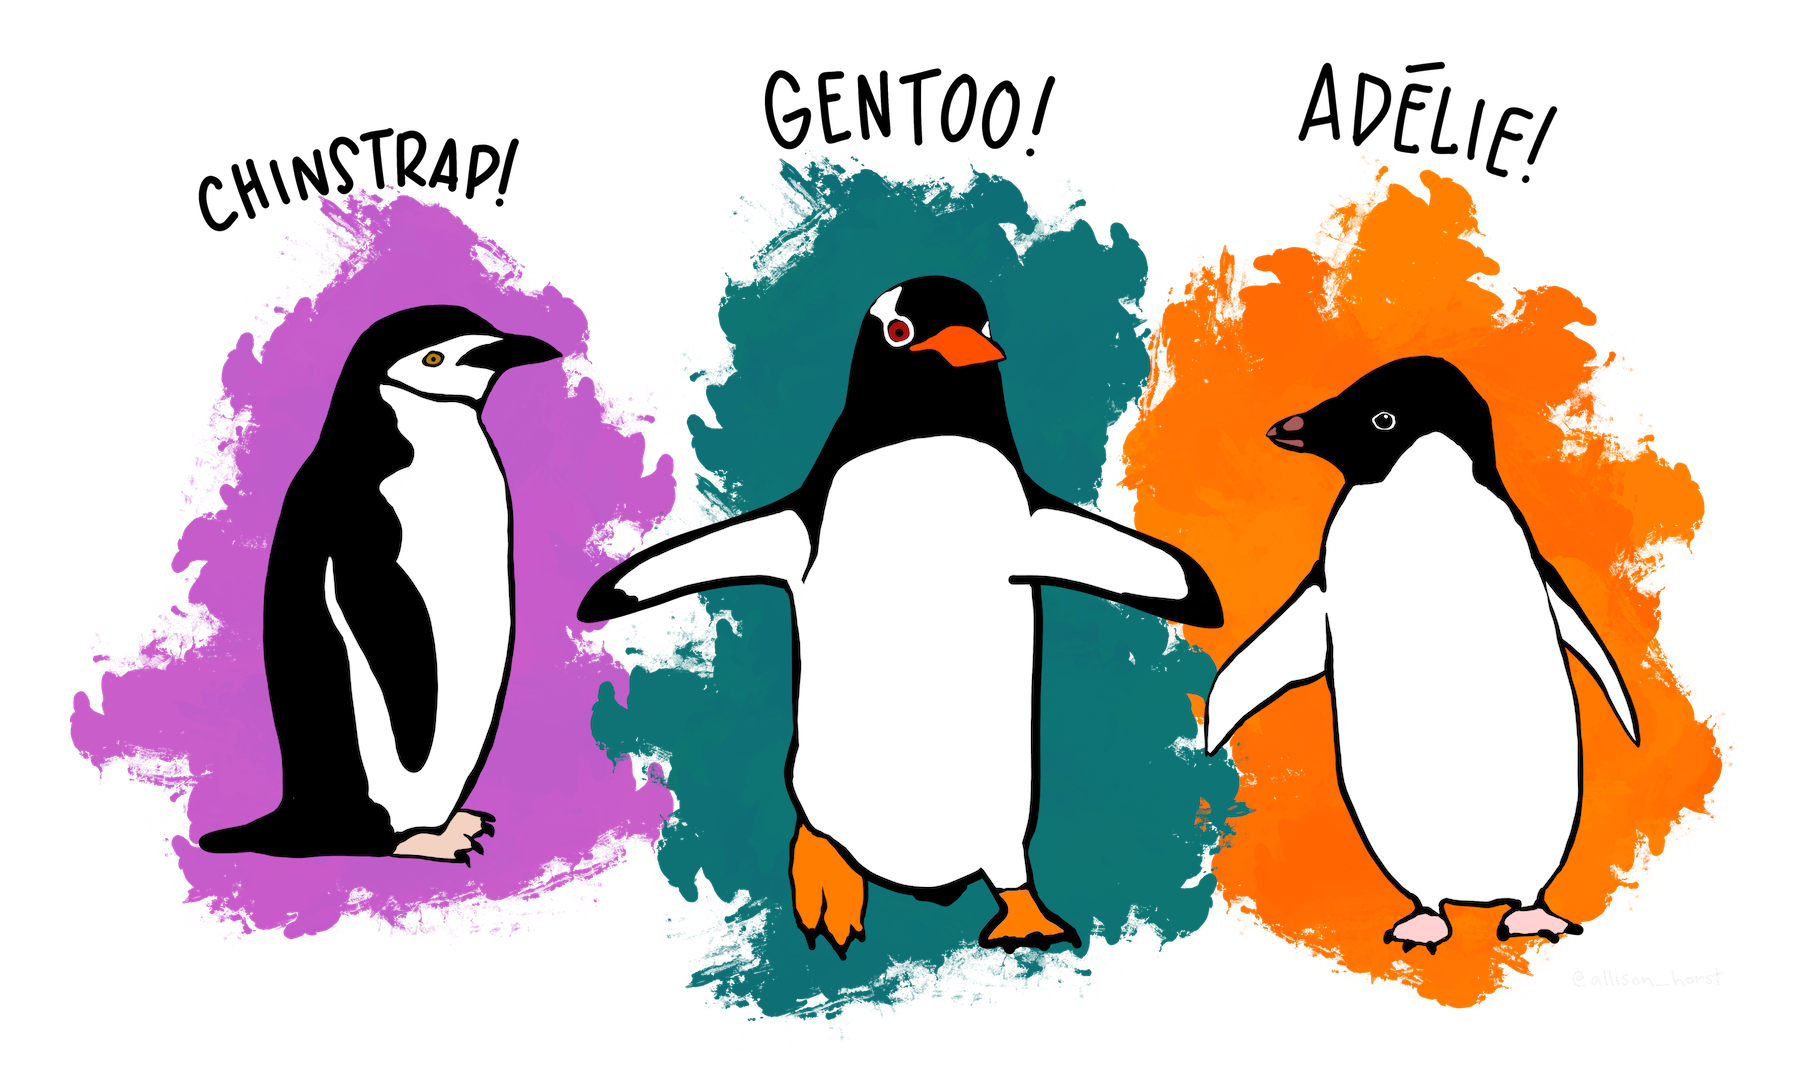
Exemple : manchots de Palmer

Exemple : bibliothèque manquante

try:
    from palmerpenguins import load_penguins
except ModuleNotFoundError:
    %pip install -q palmerpenguins
    from palmerpenguins import load_penguins

Exemple : chargement des données

# Il est d'usage d'utiliser X et y pour les données et les étiquettes

X, y = load_penguins(return_X_y = True)

# Retirer les lignes qui contiennent des mesures manquantes

X = X.dropna()
y = y.loc[X.index]

Exemple : utilisation d’un arbre de décision

from sklearn import tree

clf = tree.DecisionTreeClassifier(criterion="entropy", random_state=42)

Exemple : entraînement

# Entraînement

clf = clf.fit(X, y)

Exemple : visualisation (1/2)

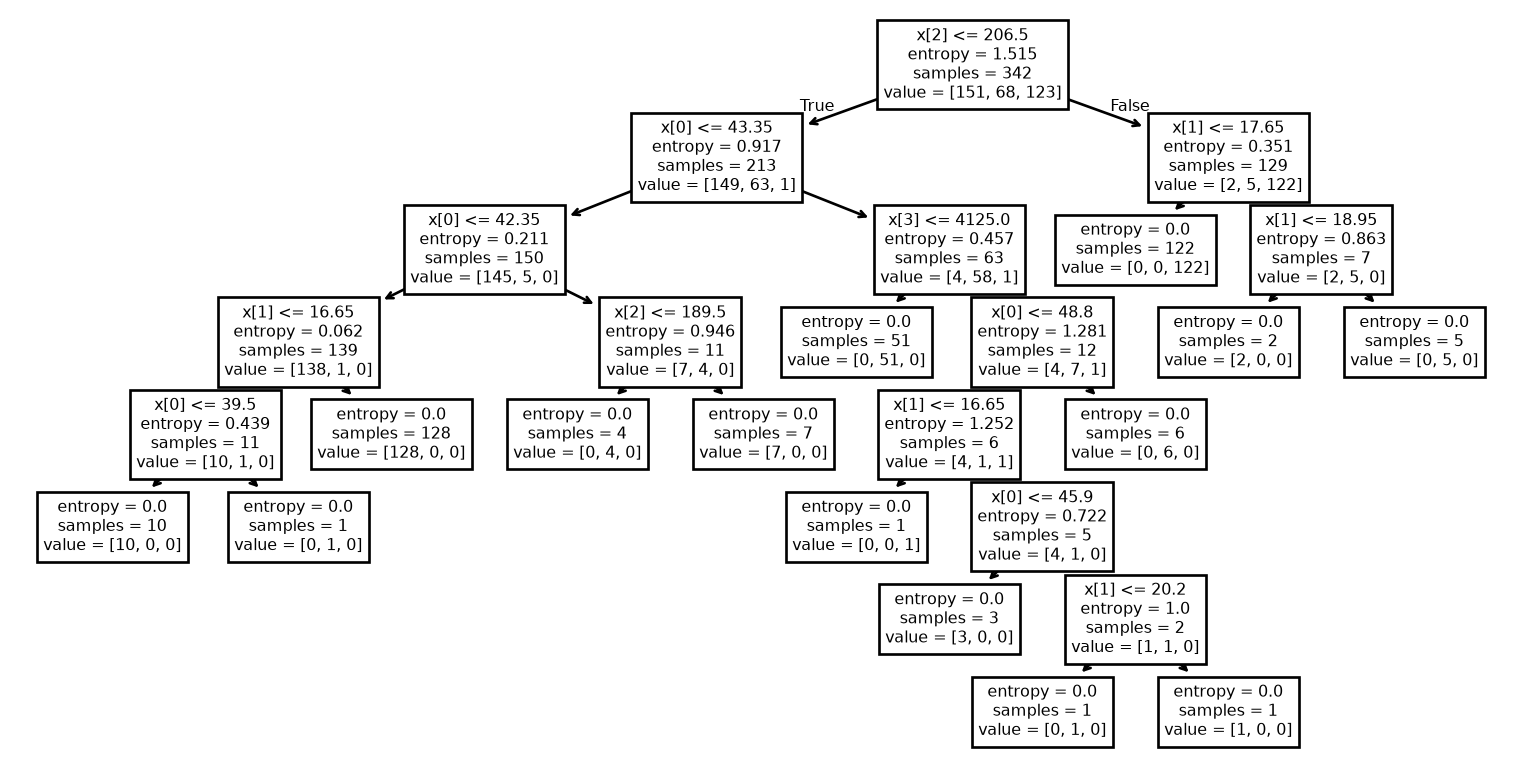
import matplotlib.pyplot as plt

tree.plot_tree(clf)
plt.show()

Exemple : visualisation (2/2)

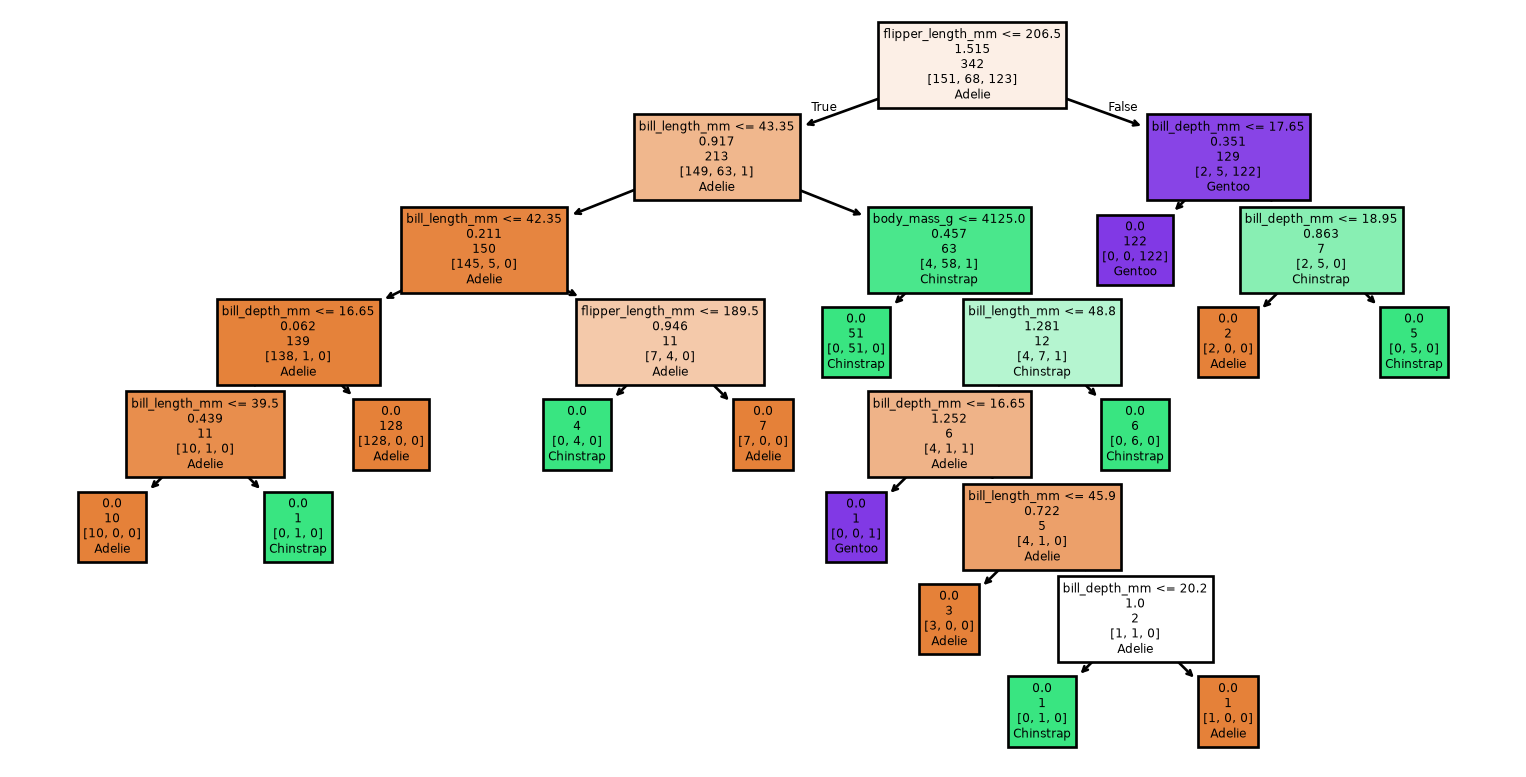
target_names = clf.classes_

tree.plot_tree(clf, 
               feature_names = X.columns,
               class_names = target_names,
               label = 'none',
               filled = True)
plt.show()

Exemple : prédiction

import pandas as pd

# Créer deux nouveaux exemples

column_names = ['bill_length_mm', 'bill_depth_mm', 'flipper_length_mm', 'body_mass_g']
new_penguins = pd.DataFrame(
    [[34.2, 17.9, 186.8, 2945.0], [51.0, 15.2, 223.7, 5560.0]],
    columns=column_names,
)

# Prédiction

predictions = clf.predict(new_penguins)

# Affichage des étiquettes prédites pour nos deux exemples

print(predictions)
['Adelie' 'Gentoo']

Exemple : exemple complet

X, y = load_penguins(return_X_y = True)
X = X.dropna()
y = y.loc[X.index]
clf = tree.DecisionTreeClassifier(criterion="entropy", random_state=42)
clf = clf.fit(X, y)
tree.plot_tree(clf)
new_penguins = pd.DataFrame(
    [[34.2, 17.9, 186.8, 2945.0], [51.0, 15.2, 223.7, 5560.0]],
    columns=column_names,
)
print(clf.predict(new_penguins))
['Adelie' 'Gentoo']

Exemple : performance apparente

from sklearn.metrics import classification_report, accuracy_score

# Faire des prédictions

y_pred = clf.predict(X)

# Évaluer le modèle

accuracy = accuracy_score(y, y_pred)
report = classification_report(y, y_pred, labels=clf.classes_, target_names=clf.classes_)

print(f'Exactitude : {accuracy:.2f}')
print('Rapport de classification :')
print(report)

Exemple : performance apparente

Exactitude : 1.00
Rapport de classification :
              precision    recall  f1-score   support

      Adelie       1.00      1.00      1.00       151
   Chinstrap       1.00      1.00      1.00        68
      Gentoo       1.00      1.00      1.00       123

    accuracy                           1.00       342
   macro avg       1.00      1.00      1.00       342
weighted avg       1.00      1.00      1.00       342

Exemple : discussion

Nous avons démontré un exemple complet :

  • Chargement des données
  • Sélection d’un classificateur
  • Entraînement du modèle
  • Visualisation du modèle
  • Faire une prédiction

Exemple : attendez une minute!

from sklearn.metrics import classification_report, accuracy_score

# Faire des prédictions

y_pred = clf.predict(X)

# Évaluer le modèle

accuracy = accuracy_score(y, y_pred)
report = classification_report(y, y_pred, labels=clf.classes_, target_names=clf.classes_)

print(f'Exactitude : {accuracy:.2f}')
print('Rapport de classification :')
print(report)

Important

Cet exemple est trompeur, voire erroné !

Exemple : exploration

penguins = load_penguins()
type(penguins)
pandas.DataFrame
penguins.head()

Exemple : exploration

species island bill_length_mm bill_depth_mm flipper_length_mm body_mass_g sex year
0 Adelie Torgersen 39.1 18.7 181.0 3750.0 male 2007
1 Adelie Torgersen 39.5 17.4 186.0 3800.0 female 2007
2 Adelie Torgersen 40.3 18.0 195.0 3250.0 female 2007
3 Adelie Torgersen NaN NaN NaN NaN NaN 2007
4 Adelie Torgersen 36.7 19.3 193.0 3450.0 female 2007

Exemple : exploration

penguins.describe()

Exemple : exploration

bill_length_mm bill_depth_mm flipper_length_mm body_mass_g year
count 342.000000 342.000000 342.000000 342.000000 344.000000
mean 43.921930 17.151170 200.915205 4201.754386 2008.029070
std 5.459584 1.974793 14.061714 801.954536 0.818356
min 32.100000 13.100000 172.000000 2700.000000 2007.000000
25% 39.225000 15.600000 190.000000 3550.000000 2007.000000
50% 44.450000 17.300000 197.000000 4050.000000 2008.000000
75% 48.500000 18.700000 213.000000 4750.000000 2009.000000
max 59.600000 21.500000 231.000000 6300.000000 2009.000000

Exemple : utilisation de seaborn

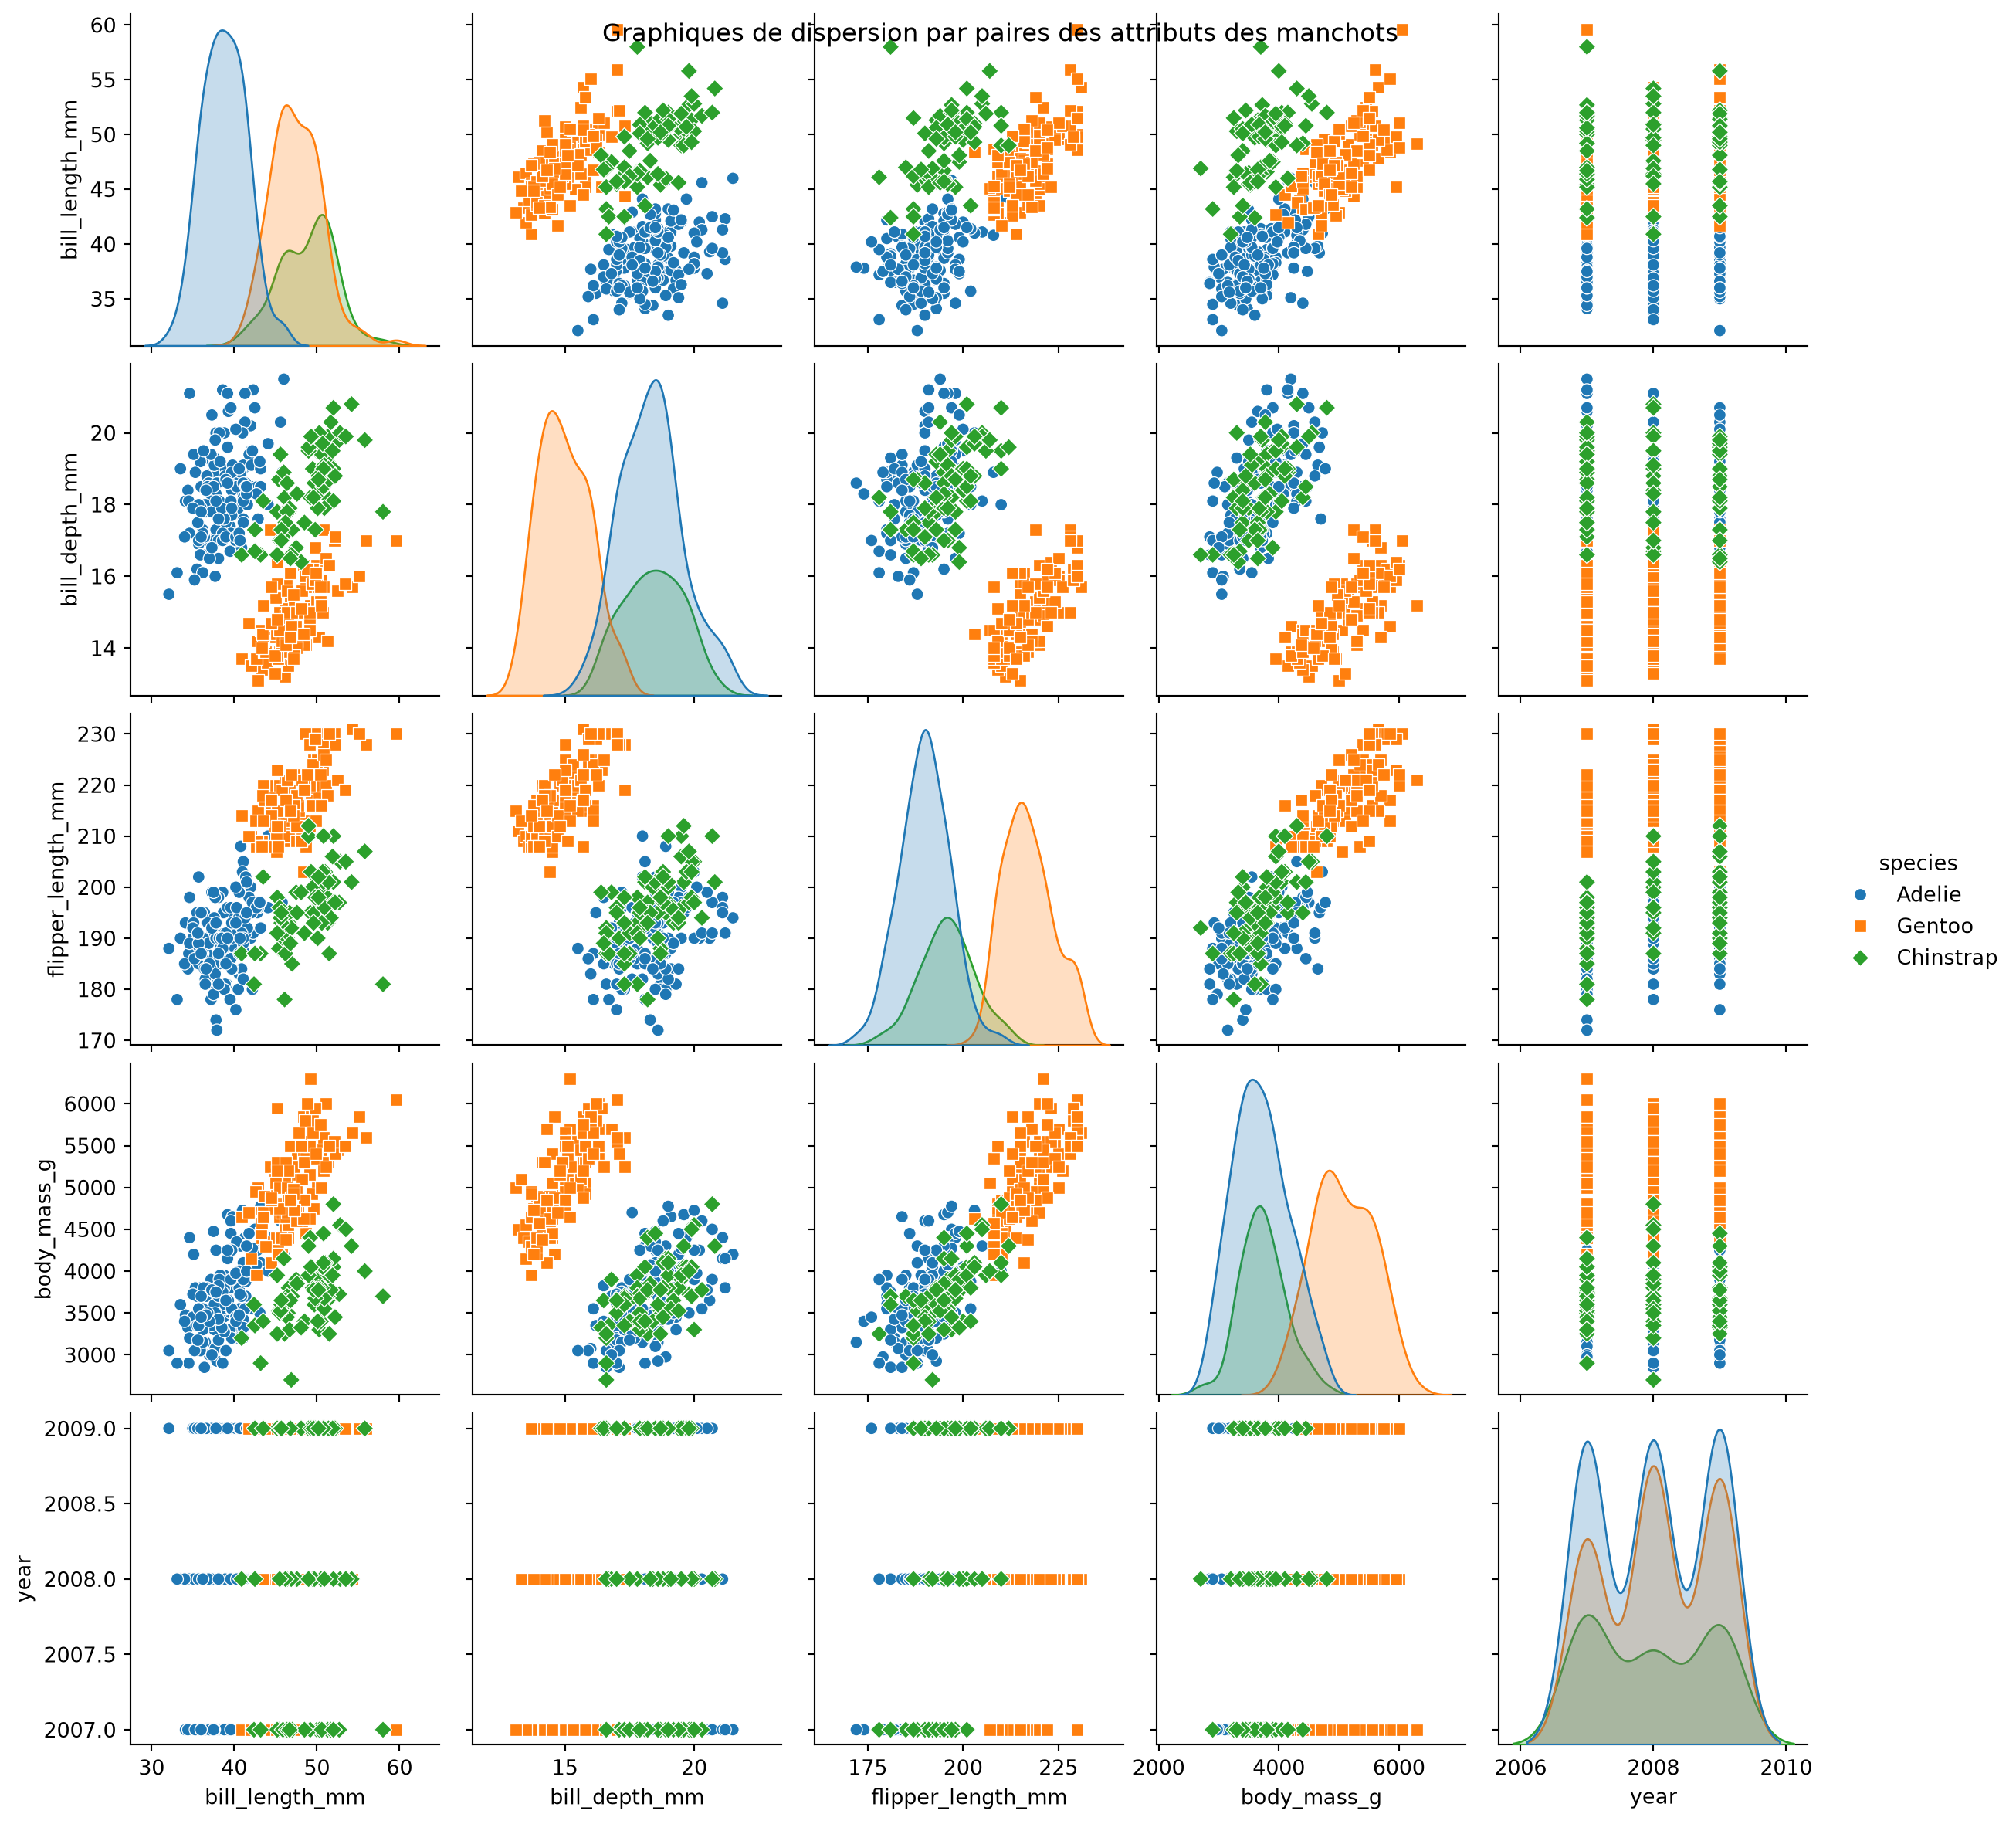
import seaborn as sns

# Graphiques par paires avec seaborn

sns.pairplot(penguins, hue='species', markers=["o", "s", "D"])
plt.suptitle("Graphiques de dispersion par paires des attributs des manchots")
plt.show()

Exemple : utilisation de seaborn

Exemple : jeux d’entraînement et de test

from sklearn.model_selection import train_test_split

# Diviser le jeu de données en ensembles d'entraînement et de test

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=7,
    stratify=y,
)

Exemple : création d’un nouveau classificateur

clf = tree.DecisionTreeClassifier(criterion="entropy", random_state=42)

Exemple : entraînement du nouveau classificateur

clf.fit(X_train, y_train)

Exemple : visualisation de l’arbre

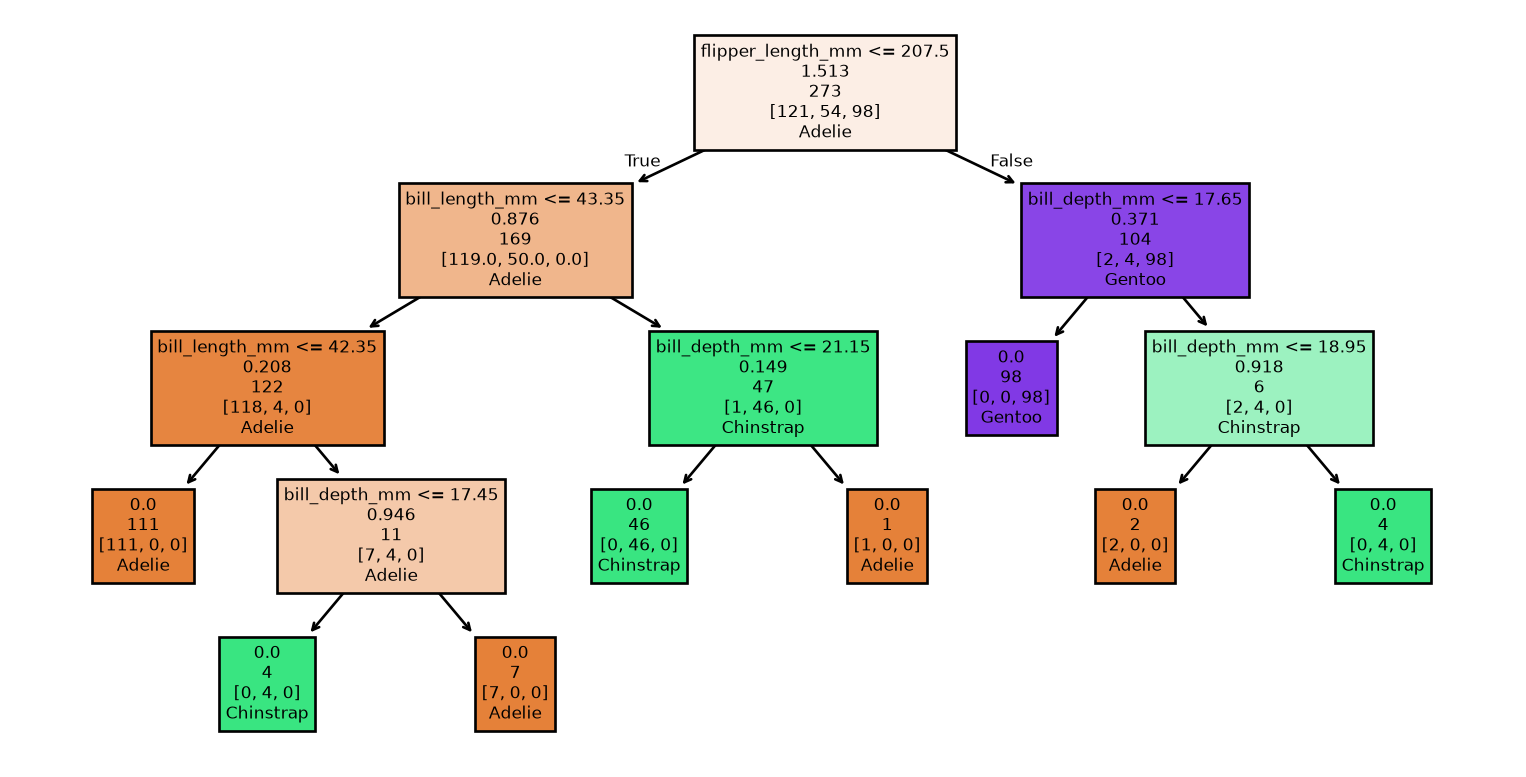
tree.plot_tree(clf, 
               feature_names = X.columns,
               class_names = target_names,
               label = 'none',
               filled = True)
plt.show()

Exemple : prédictions

# Faire des prédictions
y_pred = clf.predict(X_test)

Exemple : mesure de la performance

# Évaluer le modèle
accuracy = accuracy_score(y_test, y_pred)
report = classification_report(
    y_test,
    y_pred,
    labels=clf.classes_,
    target_names=clf.classes_,
)

print(f'Exactitude : {accuracy:.2f}')
print('Rapport de classification :')
print(report)

Exemple : mesure de la performance

Exactitude : 0.91
Rapport de classification :
              precision    recall  f1-score   support

      Adelie       0.96      0.90      0.93        30
   Chinstrap       0.72      0.93      0.81        14
      Gentoo       1.00      0.92      0.96        25

    accuracy                           0.91        69
   macro avg       0.90      0.92      0.90        69
weighted avg       0.93      0.91      0.92        69

Résumé

  • Nous avons distingué l’apprentissage supervisé, non supervisé et par renforcement selon la rétroaction disponible.
  • Nous avons identifié les exemples, les attributs et les cibles d’un problème supervisé.
  • Nous avons appliqué le flux de travail de scikit-learn au jeu de données des manchots de Palmer.
  • Nous avons exploré les données, entraîné un classificateur et effectué des prédictions.
  • Nous avons utilisé un jeu de test distinct pour estimer la performance sur des données inédites.

Prologue

Lectures supplémentaires (1/3)

  • The Hundred-Page Machine Learning Book (Burkov 2019) est un manuel succinct et ciblé qui peut être lu en une semaine, ce qui en fait une excellente ressource d’introduction.
  • Disponible sous un modèle « lire d’abord, acheter ensuite », permettant aux lecteurs d’évaluer son contenu avant de l’acheter.
  • Son auteur, Andriy Burkov, a obtenu son doctorat en IA à l’Université Laval.

Lectures supplémentaires (2/3)

Lectures supplémentaires (3/3)

  • Mathematics for Machine Learning (Deisenroth et al. 2020) vise à fournir les compétences mathématiques nécessaires pour lire des livres sur l’apprentissage automatique.
  • PDF du livre
  • “Ce livre offre une excellente couverture de tous les concepts mathématiques de base pour l’apprentissage automatique. J’ai hâte de le partager avec les étudiants, les collègues et toute personne intéressée à acquérir une compréhension solide des fondamentaux.” Joelle Pineau, Université McGill et Facebook

Références

Burkov, Andriy. 2019. The Hundred-Page Machine Learning Book. Andriy Burkov.
Deisenroth, Marc Peter, A. Aldo Faisal, et Cheng Soon Ong. 2020. Mathematics for Machine Learning. Cambridge University Press. https://doi.org/10.1017/9781108679930.
Géron, Aurélien. 2022. Hands-on Machine Learning with Scikit-Learn, Keras, and TensorFlow. 3ᵉ éd. O’Reilly Media, Inc.
Kingsford, C, et Steven L Salzberg. 2008. « What are decision trees? » Nature biotechnology 26 (9): 1011‑13. https://doi.org/10.1038/nbt0908-1011.
Mitchell, Tom M. 1997. Machine Learning. McGraw-Hill.
Russell, Stuart, et Peter Norvig. 2020. Artificial Intelligence: A Modern Approach. 4ᵉ éd. Pearson. http://aima.cs.berkeley.edu/.

Prochain cours

  • Arbres de décision et entropie
  • Frontières de décision et régression logistique
  • K plus proches voisins

Annexe : jeu de données Iris

Exemple : jeu de données Iris

Exemple : chargement des données

from sklearn.datasets import load_iris

# Charger le jeu de données Iris

iris = load_iris()

Exemple : utilisation d’un arbre de décision

from sklearn import tree

clf = tree.DecisionTreeClassifier(criterion="entropy", random_state=42)

Exemple : entraînement

# Par convention, X désigne les données et y les cibles

X, y = iris.data, iris.target

# Entraînement

clf = clf.fit(X, y)

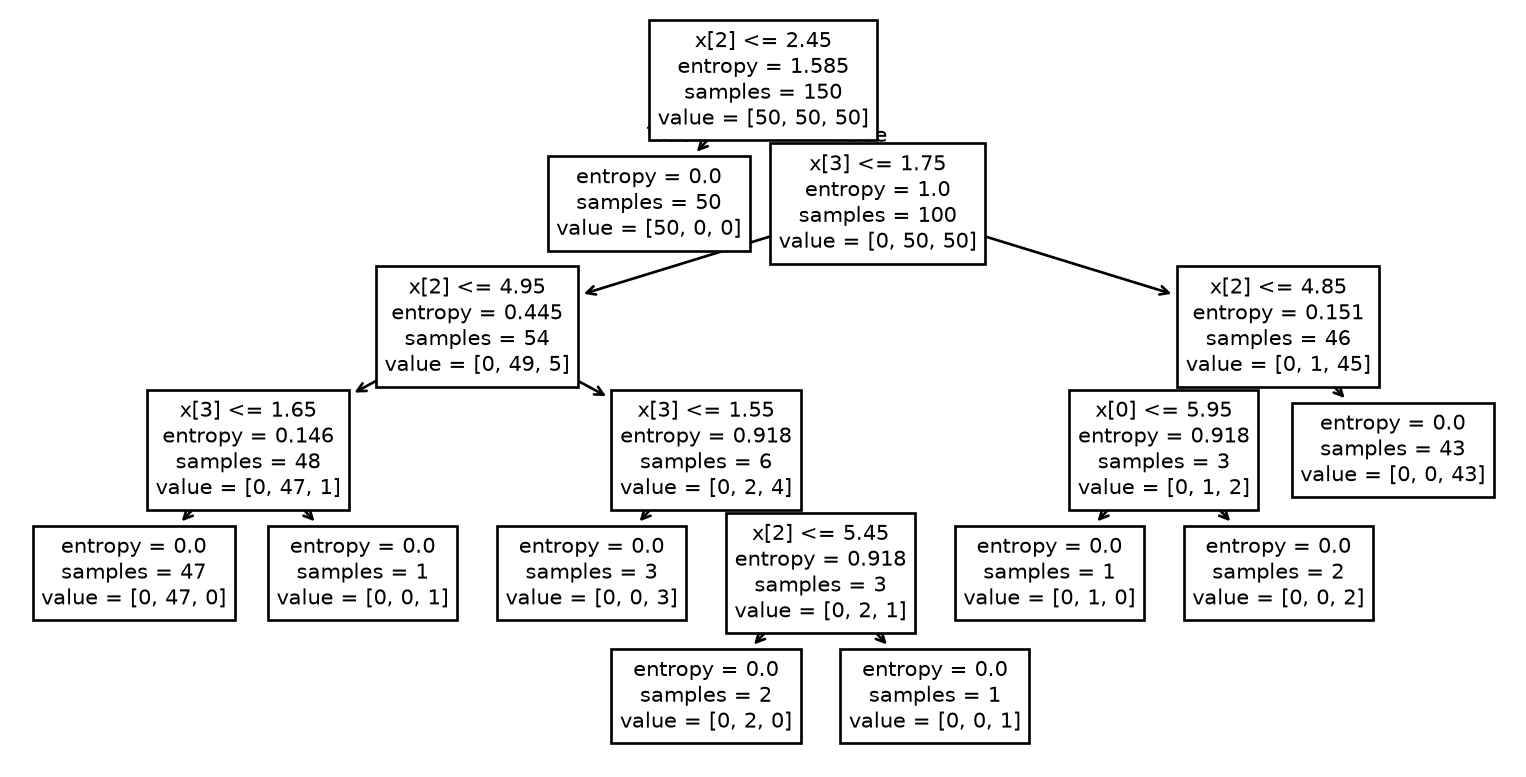
Exemple : visualisation de l’arbre (1/2)

import matplotlib.pyplot as plt

tree.plot_tree(clf)
plt.show()

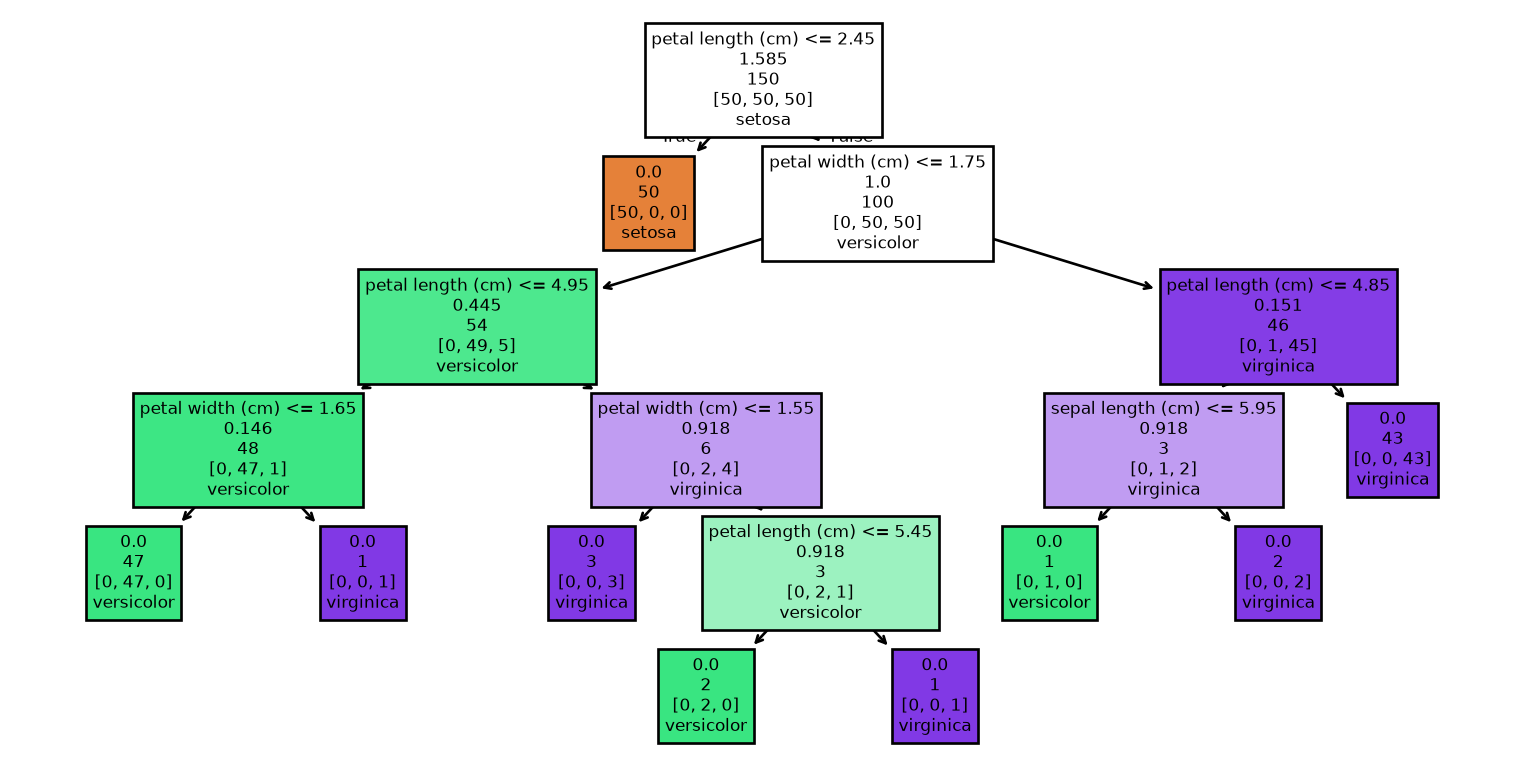
Exemple : visualisation de l’arbre (2/2)

tree.plot_tree(clf, 
               feature_names=iris.feature_names, 
               class_names=iris.target_names,
               label='none',
               filled=True)
plt.show()

Exemple : prédiction

# Créer deux nouveaux exemples
# 'sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)'

new_irises = [[5.1, 3.5, 1.4, 0.2], [6.7, 3.0, 5.2, 2.3]]

# Prédiction

predictions = clf.predict(new_irises)

# Afficher les classes prédites

print(iris.target_names[predictions])
['setosa' 'virginica']

Exemple : complet

iris = load_iris()
clf = tree.DecisionTreeClassifier(criterion="entropy", random_state=42)
X, y = iris.data, iris.target
clf = clf.fit(X, y)
tree.plot_tree(clf)
new_irises = [[5.1, 3.5, 1.4, 0.2], [6.7, 3.0, 5.2, 2.3]]
predictions = clf.predict(new_irises)
print(iris.target_names[predictions])
['setosa' 'virginica']

Exemple : performance

from sklearn.metrics import classification_report, accuracy_score

# Faire des prédictions

y_pred = clf.predict(X)

# Évaluer le modèle

accuracy = accuracy_score(y, y_pred)
report = classification_report(y, y_pred, target_names=iris.target_names)

print(f'Exactitude : {accuracy:.2f}')
print('Rapport de classification :')
print(report)

Exemple : performance

Exactitude : 1.00
Rapport de classification :
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        50
  versicolor       1.00      1.00      1.00        50
   virginica       1.00      1.00      1.00        50

    accuracy                           1.00       150
   macro avg       1.00      1.00      1.00       150
weighted avg       1.00      1.00      1.00       150

Exemple : discussion

Nous avons vu un exemple complet :

  • Chargement des données
  • Sélection d’un classificateur
  • Entraînement du modèle
  • Visualisation du modèle
  • Réalisation d’une prédiction

Exemple : deuxième tentative

from sklearn.metrics import classification_report, accuracy_score

# Faire des prédictions

y_pred = clf.predict(X)

# Évaluer le modèle

accuracy = accuracy_score(y, y_pred)
report = classification_report(y, y_pred, target_names=iris.target_names)

print(f'Exactitude : {accuracy:.2f}')
print('Rapport de classification :')
print(report)

Important

Cet exemple est trompeur, voire erroné!

Exemple : exploration

print(f'Description du jeu de données :\n{iris["DESCR"]}\n')
Description du jeu de données :
.. _iris_dataset:

Iris plants dataset
--------------------

**Data Set Characteristics:**

:Number of Instances: 150 (50 in each of three classes)
:Number of Attributes: 4 numeric, predictive attributes and the class
:Attribute Information:
    - sepal length in cm
    - sepal width in cm
    - petal length in cm
    - petal width in cm
    - class:
            - Iris-Setosa
            - Iris-Versicolour
            - Iris-Virginica

:Summary Statistics:

============== ==== ==== ======= ===== ====================
                Min  Max   Mean    SD   Class Correlation
============== ==== ==== ======= ===== ====================
sepal length:   4.3  7.9   5.84   0.83    0.7826
sepal width:    2.0  4.4   3.05   0.43   -0.4194
petal length:   1.0  6.9   3.76   1.76    0.9490  (high!)
petal width:    0.1  2.5   1.20   0.76    0.9565  (high!)
============== ==== ==== ======= ===== ====================

:Missing Attribute Values: None
:Class Distribution: 33.3% for each of 3 classes.
:Creator: R.A. Fisher
:Donor: Michael Marshall (MARSHALL%PLU@io.arc.nasa.gov)
:Date: July, 1988

The famous Iris database, first used by Sir R.A. Fisher. The dataset is taken
from Fisher's paper. Note that it's the same as in R, but not as in the UCI
Machine Learning Repository, which has two wrong data points.

This is perhaps the best known database to be found in the
pattern recognition literature.  Fisher's paper is a classic in the field and
is referenced frequently to this day.  (See Duda & Hart, for example.)  The
data set contains 3 classes of 50 instances each, where each class refers to a
type of iris plant.  One class is linearly separable from the other 2; the
latter are NOT linearly separable from each other.

.. dropdown:: References

  - Fisher, R.A. "The use of multiple measurements in taxonomic problems"
    Annual Eugenics, 7, Part II, 179-188 (1936); also in "Contributions to
    Mathematical Statistics" (John Wiley, NY, 1950).
  - Duda, R.O., & Hart, P.E. (1973) Pattern Classification and Scene Analysis.
    (Q327.D83) John Wiley & Sons.  ISBN 0-471-22361-1.  See page 218.
  - Dasarathy, B.V. (1980) "Nosing Around the Neighborhood: A New System
    Structure and Classification Rule for Recognition in Partially Exposed
    Environments".  IEEE Transactions on Pattern Analysis and Machine
    Intelligence, Vol. PAMI-2, No. 1, 67-71.
  - Gates, G.W. (1972) "The Reduced Nearest Neighbor Rule".  IEEE Transactions
    on Information Theory, May 1972, 431-433.
  - See also: 1988 MLC Proceedings, 54-64.  Cheeseman et al"s AUTOCLASS II
    conceptual clustering system finds 3 classes in the data.
  - Many, many more ...

Exemple : exploration

print(f'Noms des attributs : {iris.feature_names}')
Noms des attributs : ['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
print(f'Noms des classes : {iris.target_names}')
Noms des classes : ['setosa' 'versicolor' 'virginica']
print(f'Forme des données : {iris.data.shape}')
Forme des données : (150, 4)
print(f'Forme de la cible : {iris.target.shape}')
Forme de la cible : (150,)

Exemple : utilisation de pandas

import pandas as pd

# Créer un DataFrame

df = pd.DataFrame(iris.data, columns=iris.feature_names)
df['species'] = iris.target_names[iris.target]

Exemple : utilisation de pandas (suite)

# Afficher les premières lignes du DataFrame

print(df.head())
   sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)  \
0                5.1               3.5                1.4               0.2   
1                4.9               3.0                1.4               0.2   
2                4.7               3.2                1.3               0.2   
3                4.6               3.1                1.5               0.2   
4                5.0               3.6                1.4               0.2   

  species  
0  setosa  
1  setosa  
2  setosa  
3  setosa  
4  setosa  

Exemple : utilisation de pandas (suite)

# Statistiques descriptives

print(df.describe())
       sepal length (cm)  sepal width (cm)  petal length (cm)  \
count         150.000000        150.000000         150.000000   
mean            5.843333          3.057333           3.758000   
std             0.828066          0.435866           1.765298   
min             4.300000          2.000000           1.000000   
25%             5.100000          2.800000           1.600000   
50%             5.800000          3.000000           4.350000   
75%             6.400000          3.300000           5.100000   
max             7.900000          4.400000           6.900000   

       petal width (cm)  
count        150.000000  
mean           1.199333  
std            0.762238  
min            0.100000  
25%            0.300000  
50%            1.300000  
75%            1.800000  
max            2.500000  

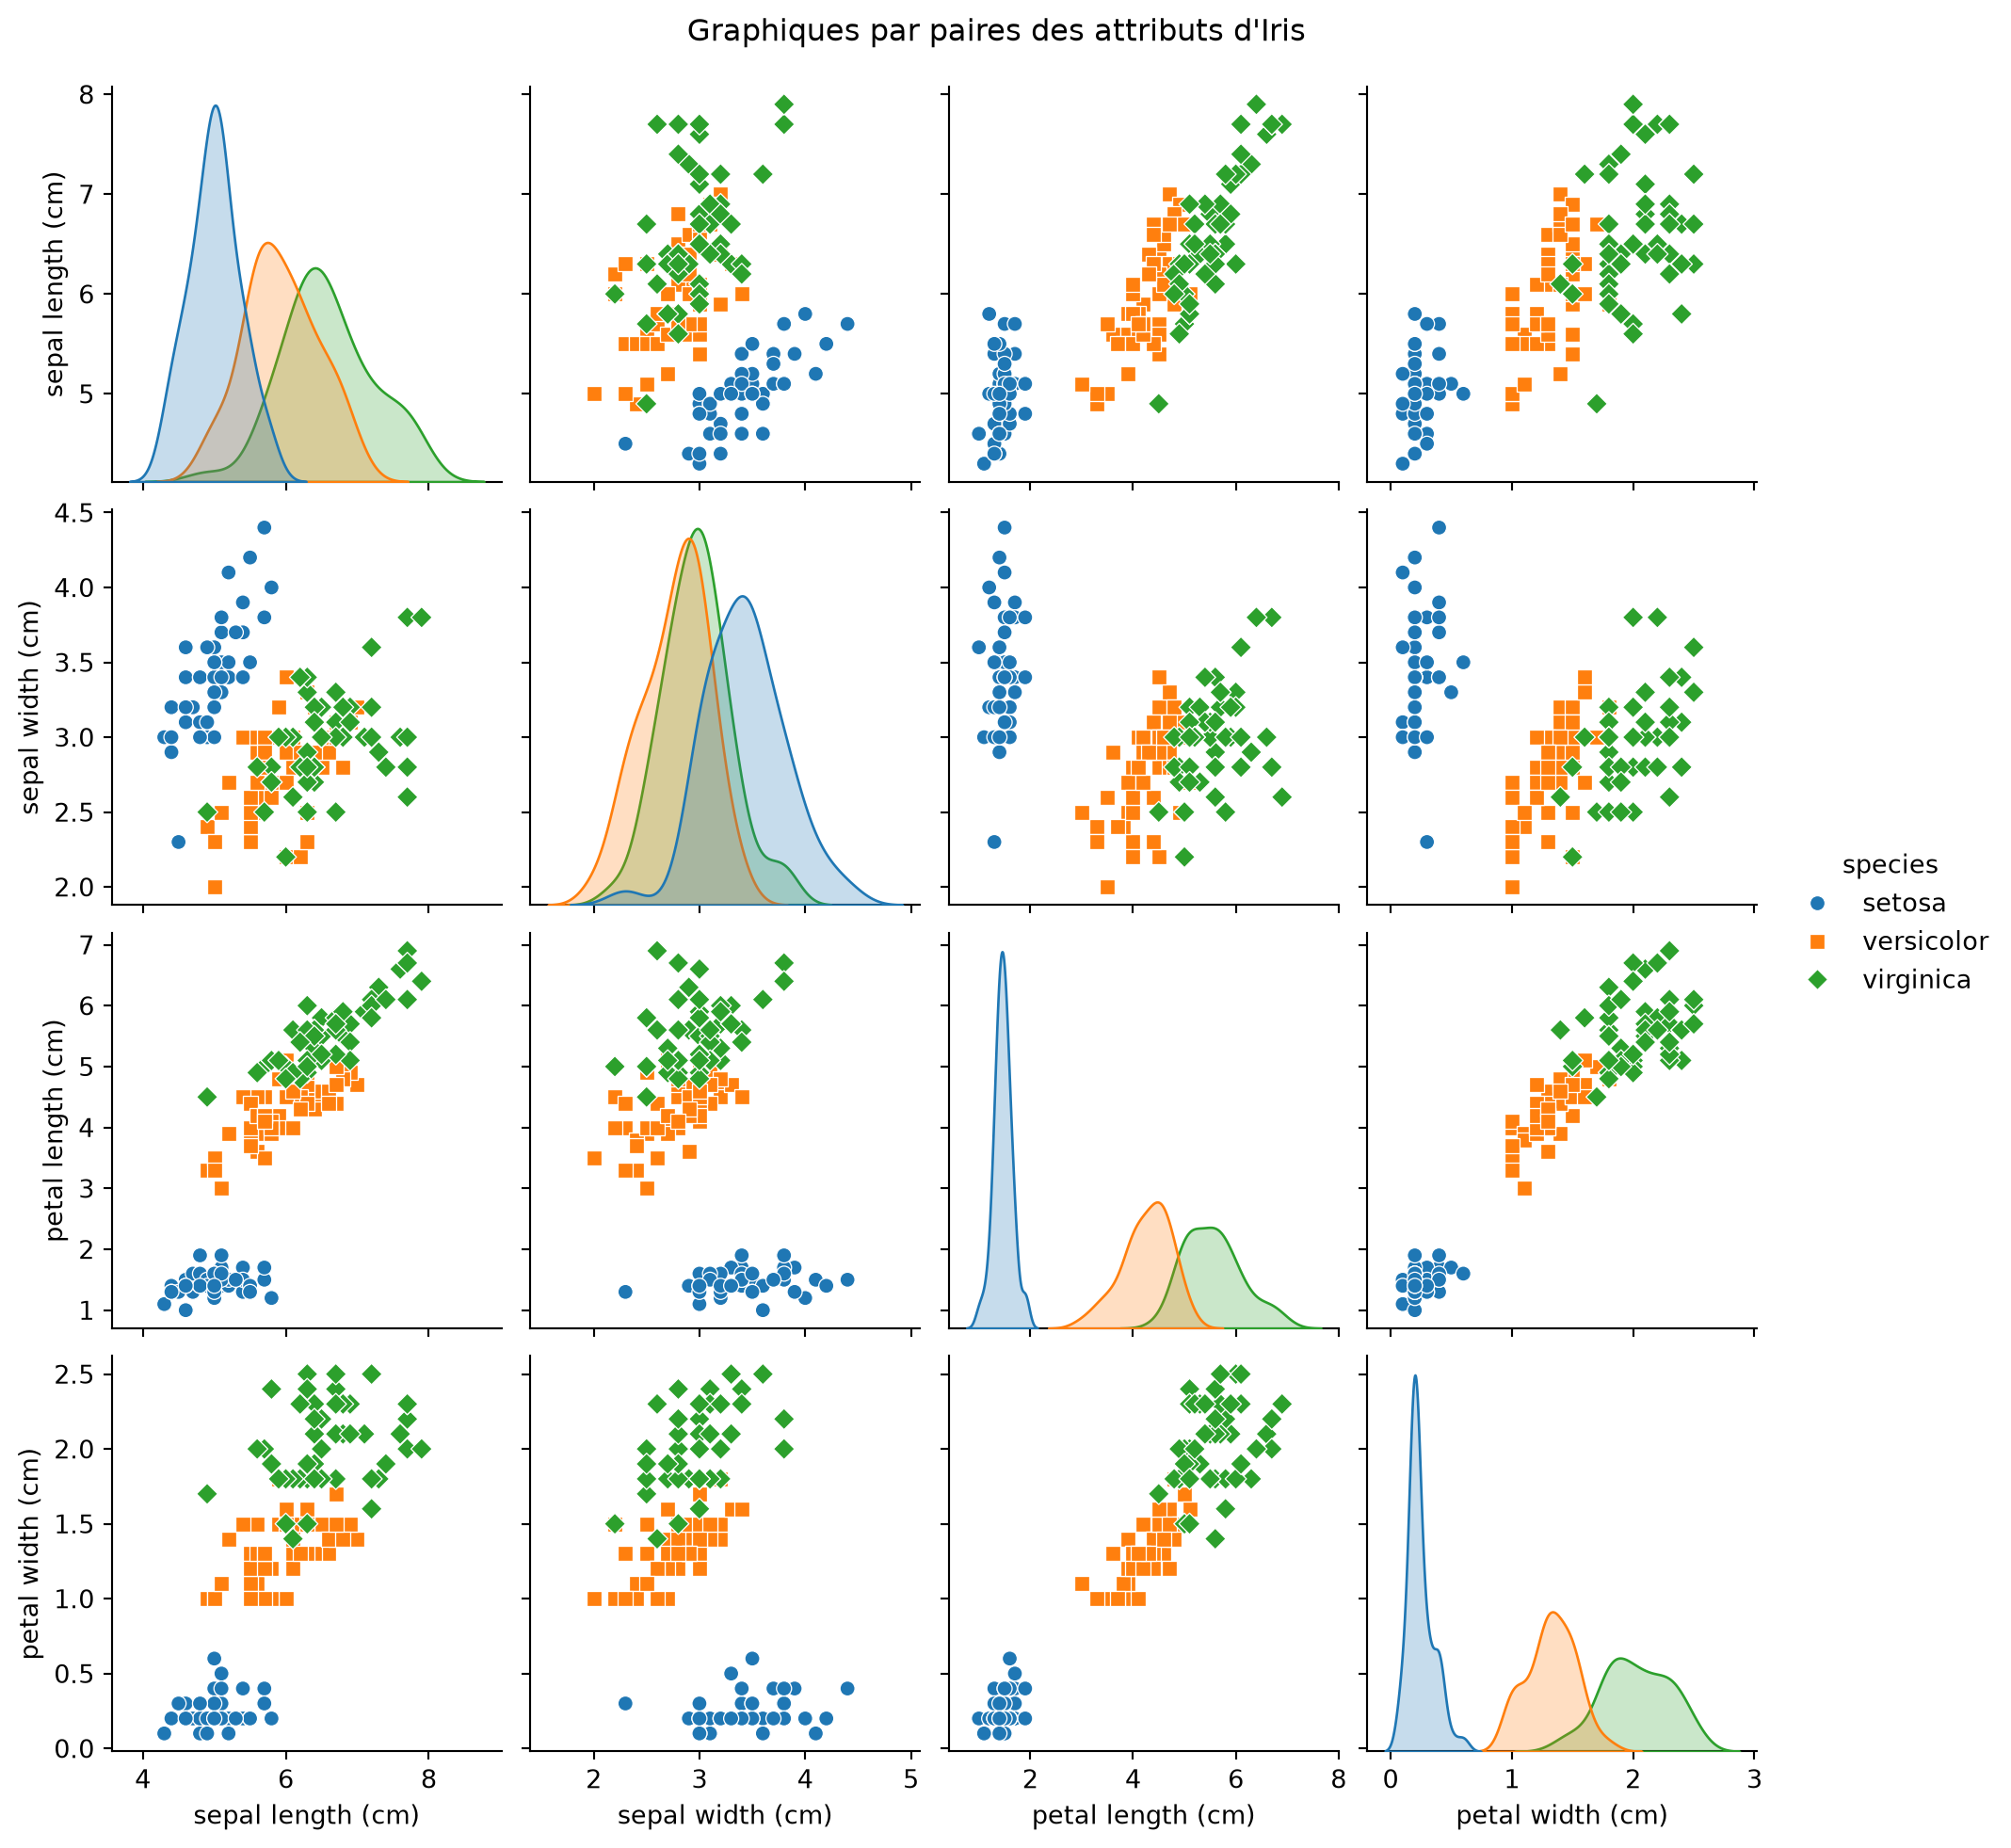
Exemple : utilisation de seaborn

import seaborn as sns

# Graphiques par paires avec seaborn

sns.pairplot(df, hue='species', markers=["o", "s", "D"])
plt.suptitle("Graphiques par paires des attributs d'Iris", y=1.02)
plt.show()

Exemple : utilisation de seaborn

Exemple : jeux d’entraînement et de test

from sklearn.model_selection import train_test_split

# Diviser les données en jeux d'entraînement et de test

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=7,
    stratify=y,
)

Exemple : création d’un nouvel arbre

clf = tree.DecisionTreeClassifier(criterion="entropy", random_state=42)

Exemple : entraînement du modèle

# Entraîner le modèle
clf.fit(X_train, y_train)

Exemple : prédictions

# Faire des prédictions
y_pred = clf.predict(X_test)

Exemple : mesure de la performance

from sklearn.metrics import classification_report, accuracy_score
# Faire des prédictions

# Évaluer le modèle
accuracy = accuracy_score(y_test, y_pred)
report = classification_report(
    y_test,
    y_pred,
    labels=clf.classes_,
    target_names=iris.target_names[clf.classes_],
)

print(f'Exactitude : {accuracy:.2f}')
print('Rapport de classification :')
print(report)

Exemple : mesure de la performance

Exactitude : 0.93
Rapport de classification :
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        10
  versicolor       0.90      0.90      0.90        10
   virginica       0.90      0.90      0.90        10

    accuracy                           0.93        30
   macro avg       0.93      0.93      0.93        30
weighted avg       0.93      0.93      0.93        30

Marcel Turcotte

Marcel.Turcotte@uOttawa.ca

École de science informatique et de génie électrique (SIGE)

Université d’Ottawa